
医疗AI智能体到底先在哪落地?哈佛斯坦福证据地图:行政工作流先行、诊断仍在路上,医生从「执行」转向「监督」
医疗AI智能体被称作数字医学的拐点,但它目前真正跑通的是哪一环?哈佛医学院与斯坦福团队在《npj Digital Medicine》发表证据地图,系统梳理诊断、管理、临床运维三类应用的落地进度,发现早期部署集中在行政工作流,医生角色正从「执行」转向「监督」。
研究背景:医疗AI智能体为何被称作「拐点」?
2022 年 11 月,ChatGPT 上线 5 天就突破 100 万用户,AI 由此进入大众视野。但那时的 AI 工具多是「只读」的:能查资料、能总结、能答问,却只输出、不行动——看完还得人自己动手。
这两年兴起的「智能体(agentic AI)」不一样了。它的核心变化在于:AI 不再只是把信息「翻译」给你看,而是直接「翻译成动作」。作者给出了一个直观对比——过去的 AI 工具,你让它「拉一份联系人名单」,它只输出一张表;而智能体能连续完成一串动作:拉出联系人、自动拨通诊所电话、再对照你的日历约时间,全程几乎不用人介入。
这种「由被动应答到主动执行」的跃迁,被作者视为数字医学的一个拐点(inflection point)。但它究竟有没有真正进入临床?进到了哪一步?此前一直没有一份系统性的梳理。
创新点:一张证据地图,把智能体落地进度盘清楚
这篇发表在《npj Digital Medicine》的观点文章,价值不在提出新模型,而在第一次把「AI 智能体在临床的真实落地现状」画成一张证据地图。作者 Joy Xu、Justin M. Ko、Joseph C. Kvedar 分属加州大学洛杉矶分校、斯坦福大学医学院与哈佛医学院,三人横跨临床、皮肤科与数字健康研究。
他们把智能体的应用场景归成三大类,逐一盘点证据:
- 诊断类:辅助阅片、辅助判断病情;
- 管理类:治疗方案建议、随访管理、慢病跟踪;
- 临床运维类(care-adjacent operations):病历补全、预约授权、检查提醒、患者消息回复、账单编码等「看病之外」的活儿。
这张地图揭示了一个反直觉但关键的结论:智能体目前跑得最顺的,恰恰是离「看病」最远的行政运维环节。
技术原理:医院AI助手如何从「被动问答」变成「主动执行」?
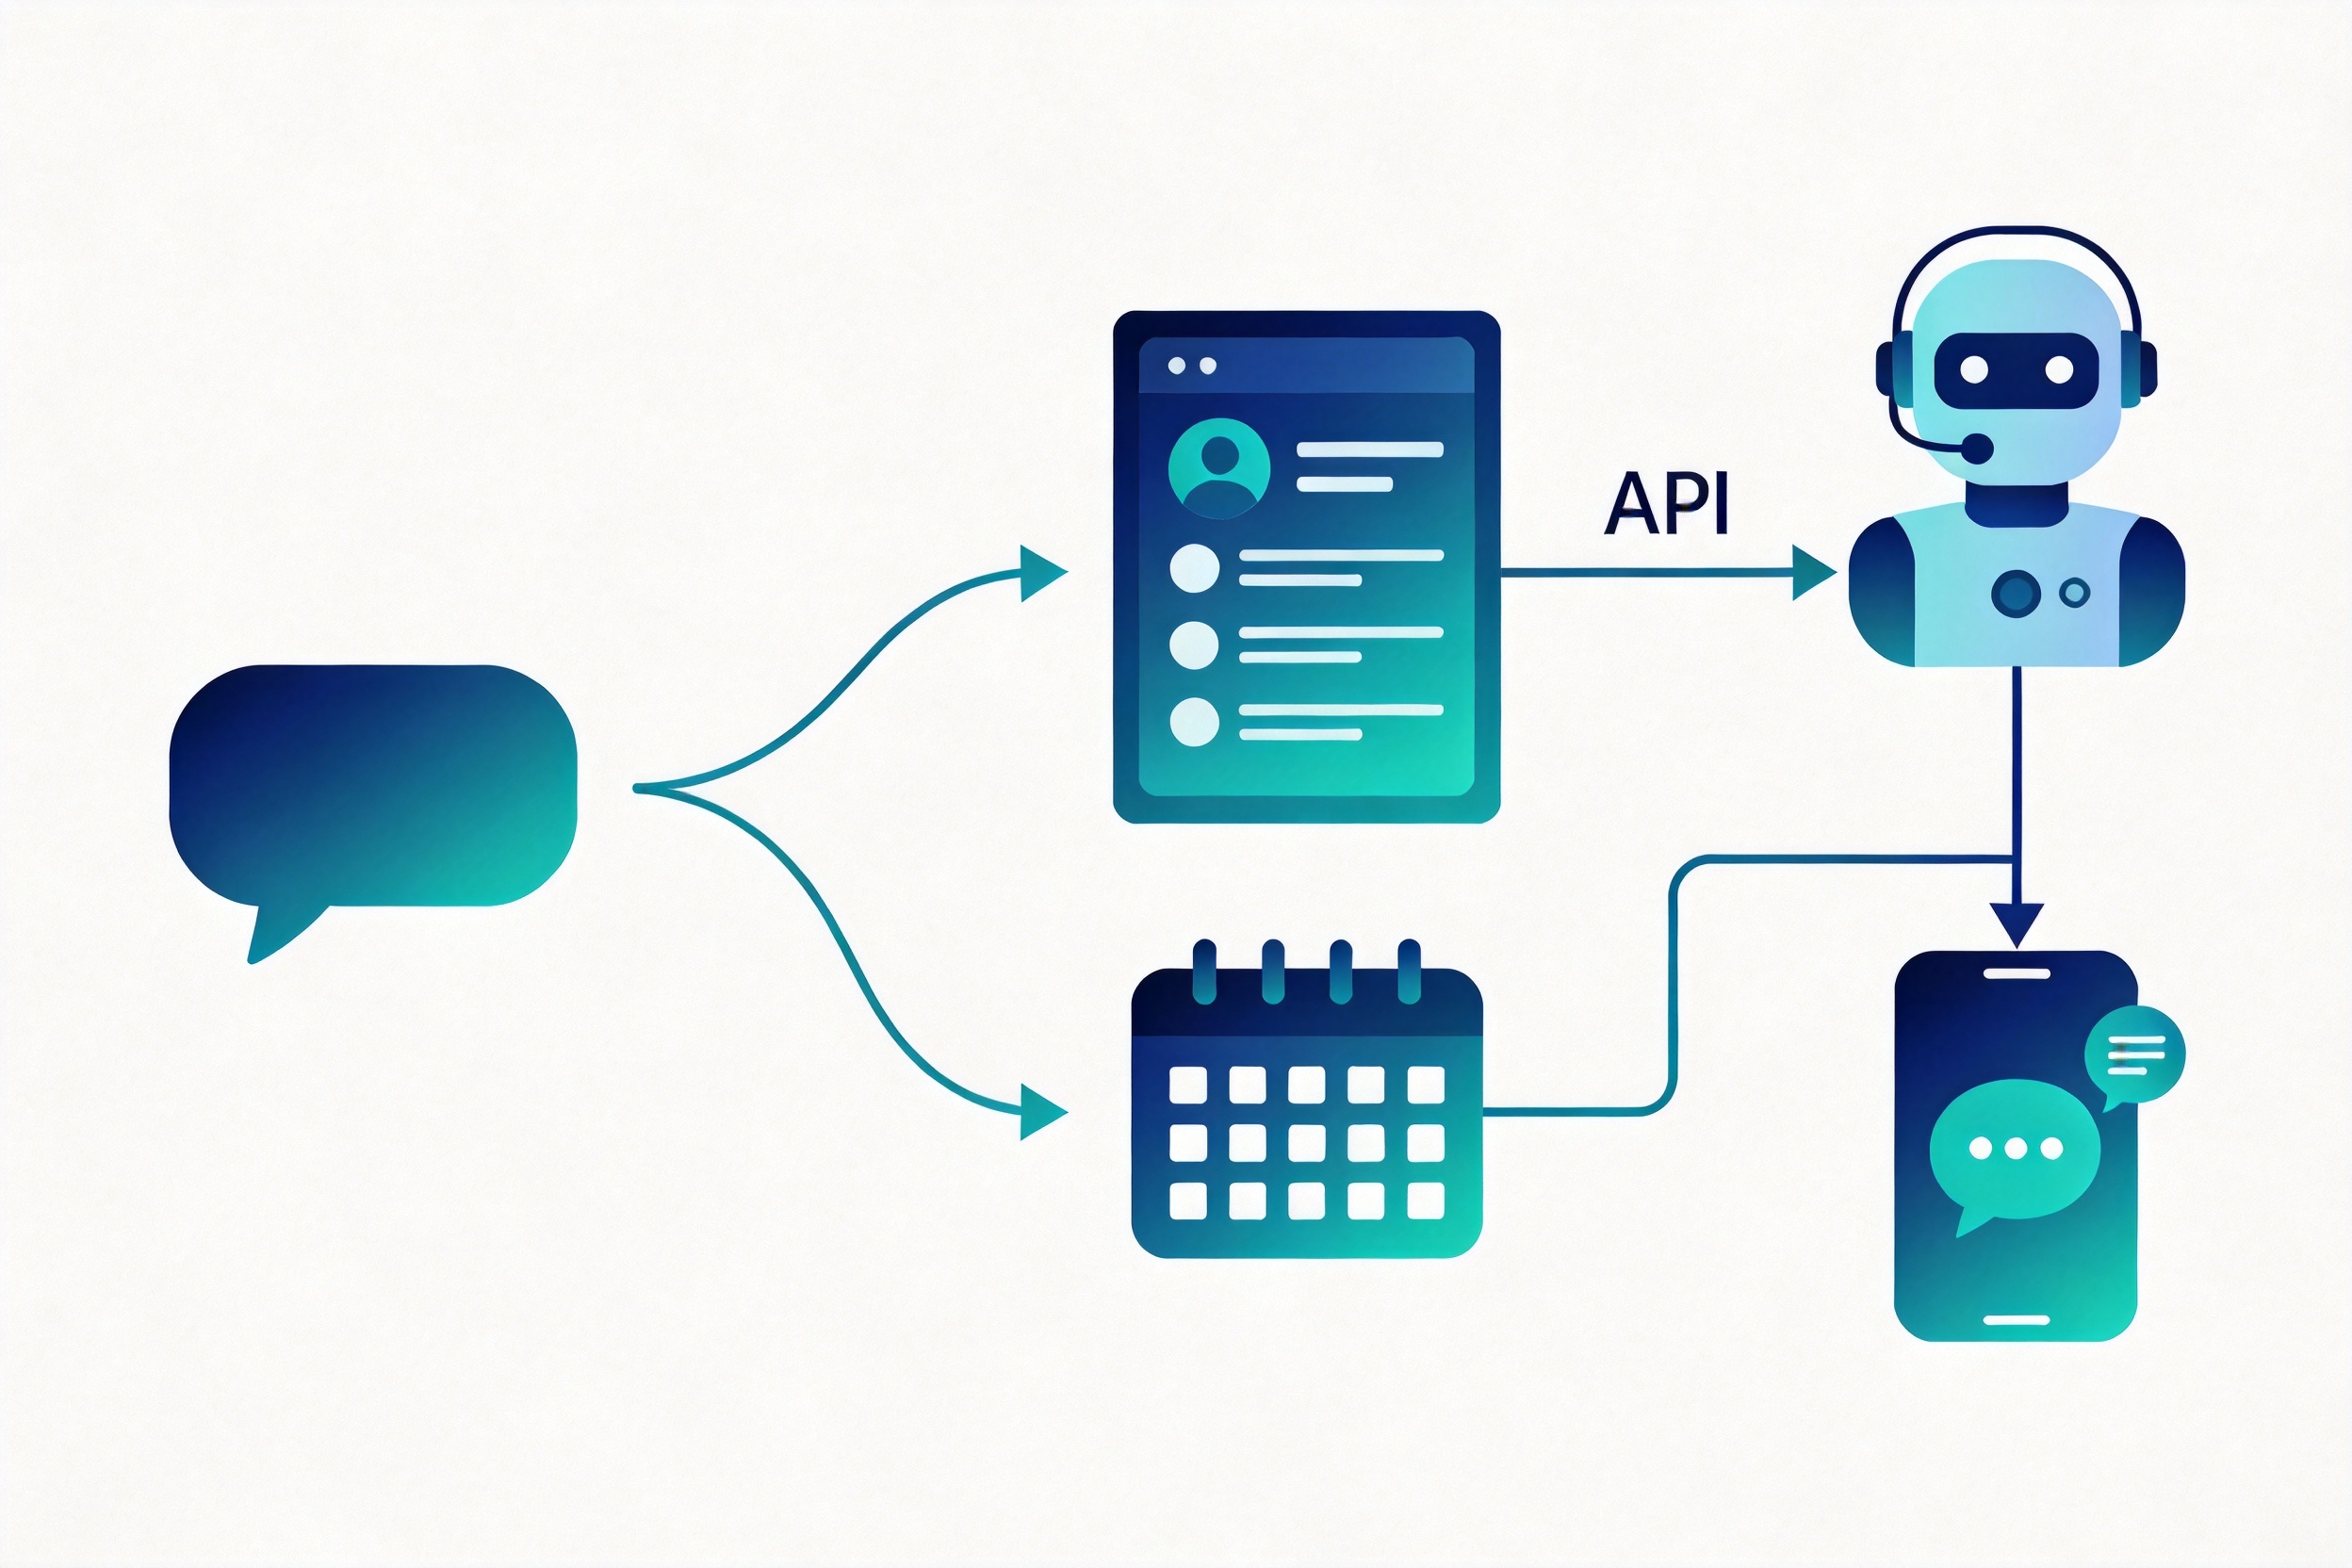
要理解这种「主动执行」,关键在于智能体与外部系统的交互方式。作者指出,智能体通过应用程序编程接口(API,即软件之间通信和数据交换的规则)与电子病历、消息系统、预约平台等外部系统对接,从而识别「没做完的事」、自己推进后续几步、在真正需要临床判断时再把医生拉回来。
以一次门诊结束后的「待办清单」为例,一个医院AI助手可以自动完成这些原本要人追着办的事:
- 发现一份未签字的病历,主动提醒;
- 整理出访后摘要,供患者带回家;
- 提醒医护团队某位患者有逾期的筛查没做;
- 起草一条对常规患者消息的回复;
- 给出账单编码建议、发起一项预约授权(prior authorization);
- 帮忙安排随访。
这些事琐碎、量大、可替代性强,正是智能体「失败也容易补救」的场景。作者认为,智能体将率先在这些行政与运营环节规模化铺开,因为这里的失败模式是可恢复的,而成功率却能带来实实在在的减负。
数据说话:先落地的不是诊断,而是行政
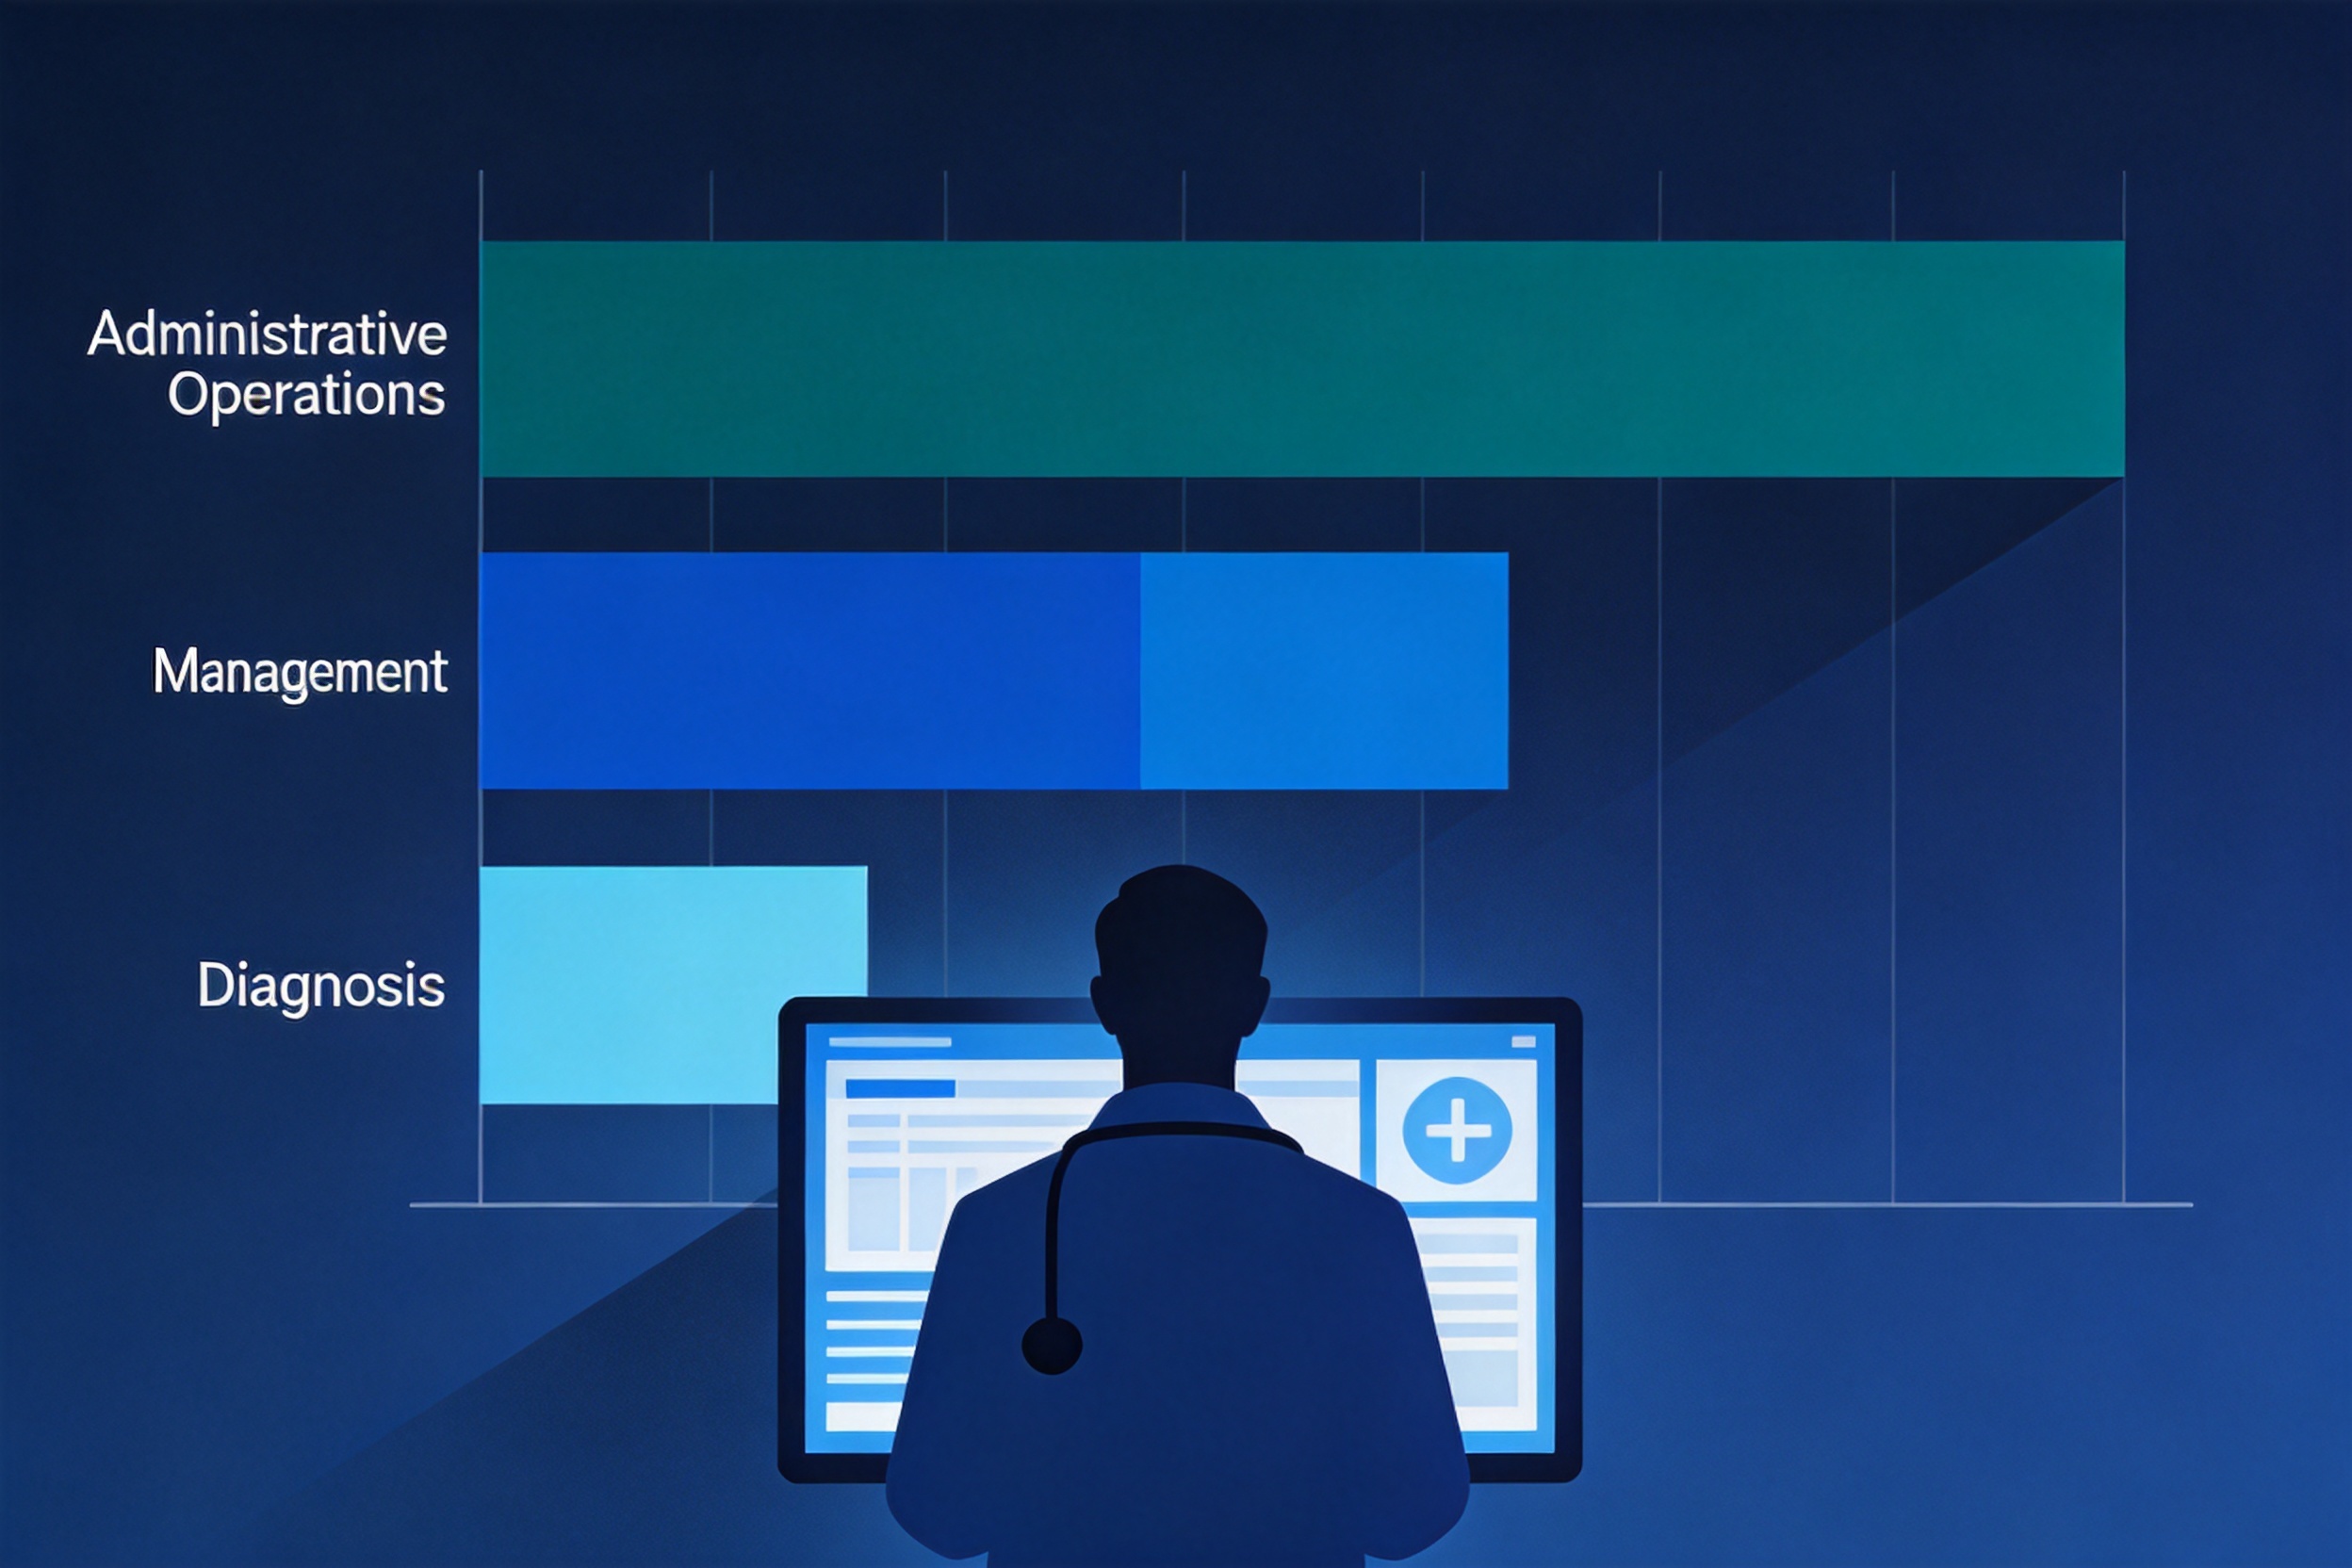
证据地图给出的信号很明确,可以用一句话概括:「智能体最先进的是行政,不是诊断。」
| 应用类别 | 当前落地状态 | 典型场景 |
|---|---|---|
| 行政运维类 | 最早、最密集 | 病历补全、预约授权、随访提醒、消息回复 |
| 管理类 | 快速扩张中 | 慢病管理、随访跟踪、治疗方案建议 |
| 诊断类 | 仍在验证 | 辅助阅片、病情判断 |
作者还点出了一个更深的转变:智能体正在把医生从「任务执行」推向「任务监督」。过去医生要亲自逐项完成预约授权这类低认知负担的琐事,现在可以由智能体自主执行、医生在一旁监控结果,医生把省下的时间与注意力,投回到真正需要专业判断的环节上。
但作者同时强调了一个前置条件:这些工具必须由「正在承受负担的医生」来定义问题,而不是由厂商来定义。只有当临床医生把「哪些环节是浪费」讲清楚、再把智能体精准匹配上去,「从执行到监督」的转变才有意义;反之,由厂商凭空定义问题,往往会遮蔽临床真正需要的东西。
应用前景与局限
这篇证据地图的意义,是给「智能体热」泼了一盆清醒而务实的水:
- 它确认了智能体的真实价值不在替代诊断,而在减负——把医生从海量行政琐事里解放出来;
- 它给出了落地的优先级判断:先啃「失败可恢复」的行政运维,再逐步向管理与诊断延伸;
- 它反复强调治理、可审计性、临床医生监督是智能体负责任的临床落地的三大前提。
局限同样要讲清楚:这是一篇观点/证据地图(perspective),不是原始对照研究,它没有给出具体的疗效或安全性量化数据;智能体在真实患者身上的前瞻性验证仍然稀缺,作者也承认,多数研究仍停留在模拟或受控环境,临床安全终点更是少有人系统评估。
结论
这篇证据地图最值得记住的一句话是:智能体进入临床,先解决的往往不是「看病」,而是「看病的周边」。
对正在部署医疗 AI 的医院和团队来说,务实的选择是——从行政运维这类「失败可恢复、成功看得见」的环节切入,把医生从琐事里解放出来;同时把治理、可审计、医生监督做在前面,而不是一上来就赌「自主诊断」。毕竟,让智能体先把「约授权、补病历、回消息」这些脏活累活干漂亮,比让它直接替医生下诊断,更稳妥、也更有现实回报。
| 论文标题 | AI agents in clinical practice: an evidence map(临床实践中的AI智能体:一份证据地图) |
| 作者 | Joy Xu、Justin M. Ko、Joseph C. Kvedar |
| 机构 | 加州大学洛杉矶分校大卫·格芬医学院(UCLA David Geffen School of Medicine)、斯坦福大学医学院(Stanford University School of Medicine)、哈佛医学院(Harvard Medical School) |
| 期刊 | npj Digital Medicine(《自然》子刊,数字医学) |
| 发表时间 | 2026 年 7 月(2025-11-04 投稿、2026-06-25 接收) |
| DOI | 10.1038/s41746-026-02960-4 |
| PubMed | PMID 42443480 |
论文原文信息地址:https://www.simoagent.com/blog/2026-10-02-ai-agents-clinical-evidence-map/
参考文献
- Xu J, Ko JM, Kvedar JC. AI agents in clinical practice: an evidence map. npj Digital Medicine, 2026. DOI: 10.1038/s41746-026-02960-4
相关问题
什么是临床决策智能体?
临床决策智能体(clinical decision agent)是一种能「主动干活」的医疗 AI——它不只回答问题,还会通过 API 连接电子病历等外部系统,自主拆解任务、推进多步操作、在需要专业判断时把医生拉回来。它和过去的「只读」AI 工具不同:前者只输出信息,后者直接把信息转化为一连串动作。这类智能体当前最成熟的应用场景是行政运维(补病历、预约授权、随访提醒),诊断与治疗决策仍在验证中。
医疗AI智能体先落地行政还是诊断?
先落地行政。哈佛/斯坦福团队在《npj Digital Medicine》的证据地图显示,智能体的早期部署集中在行政运维工作流(病历补全、预约授权、随访提醒、患者消息回复等),管理类应用在快速扩张,而诊断类仍在验证路上。核心原因是:行政环节「失败可恢复、成功看得见」,风险可控、减负明显,是智能体最稳妥的切入点。
智能体会取代医生吗?
不会,作者明确把智能体定位为「流程协作者」而非替代者。智能体的价值在于把医生从低认知负担的行政琐事里解放出来,让医生从「任务执行」转向「任务监督」,把注意力留给真正需要专业判断的环节。作者还强调,智能体的落地必须以治理、可审计性、临床医生监督为前提,并由「正在承受负担的医生」来定义问题,而不是由厂商说了算。