医疗AI行业趋势
跟踪全球医疗人工智能最新进展,深度解读技术趋势与产业动态
临床决策智能体落地到底靠检索还是靠编排?Dr.Copilot多语言智能体70天真实部署:检索增强贡献最明确,工具编排增益并不统一
给临床AI堆工具、加编排就一定更可靠吗?Dr.Copilot在70天真实部署与两轮评测中给出冷静答案:检索增强是增益最明确的组件,工具编排并未带来统一提升。
阅读全文 →
医疗AI如何像医生一样一步步问诊开检查?微软DxO多智能体编排在Science基准把复杂病例诊断准确率从全科医生36%拉到83%、成本还更低
静态选择题考不出真实诊断能力。微软DxO用多智能体编排模拟「会诊团」一步步问诊开检查,在SDBench顺序诊断基准上把复杂病例准确率拉到83%,是全科医生 …
阅读全文 →
癫痫和心因性发作为什么常被误诊?EpiScreen微调大模型读常规病历笔记早筛,人机协作让住院医师准确率最高提升约14个百分点
癫痫和心因性非癫痫发作外表很像、治疗却截然相反,光靠发作表现难区分。EpiScreen用微调大模型读常规病历笔记做早筛,AUC最高0.98,人机协作让住院医师准 …
阅读全文 →
医疗AI智能体如何从长期病历里提前预警癌症?TrajOnco免训练多智能体框架零样本覆盖15种癌种、AUROC最高0.80
癌症早筛为什么总卡在「单次化验看不出异常」上?TrajOnco用免训练的多智能体大模型框架,靠链式智能体加长期记忆对纵向电子病历做时序推理,零样本覆盖15种癌 …
阅读全文 →
医疗AI智能体加的工具越多就越可靠吗?GPT-5十种配置161例真实多模态诊断揭示「复杂度悖论」,联网搜索与多步工具反而不稳定
通用医疗AI智能体是不是越复杂越靠谱?宾夕法尼亚大学团队在npj Digital Medicine上把GPT-5的十种配置摆进161例经医生验证的真实多模态病例 …
阅读全文 →
医疗AI能安全走进真实门诊问诊吗?谷歌AMIE前瞻可行性研究:最终诊断命中九成、全程零次安全叫停,但落地性仍不及医生
谷歌对话式诊断系统AMIE首次走进真实门诊。在波士顿贝斯以色列女执事医疗中心(BIDMC)的初级保健门诊,98名患者诊前与AMIE文字问诊,医生全程监看。结果: …
阅读全文 →
眼科问诊前的病史谁来采集?双智能体LLM问诊智能体随机对照试验:问诊质量超住院医师17.7分、诊断F1达0.85
眼科问诊前的病史谁来采集?中山大学中山眼科中心团队研发双智能体LLM问诊智能体,在广州三级眼科医院开展随机对照试验:172名患者中,智能体问诊质量比住院医师 …
阅读全文 →
生成式AI放进基层诊所真能改善患者结局吗?9691例整群随机试验:AI Consult安全、病历质量显著提升,但14天治疗失败率无显著下降
生成式AI放进基层诊所,真能改善患者结局吗?英国伯明翰大学团队在肯尼亚16家基层诊所、9691例患者中开展整群随机试验,给出诚实答案:AI Consult安全、 …
阅读全文 →
罕见病为何平均超过5年才能确诊?DeepRare多智能体系统以可追溯推理诊断2919种疾病,纯表型首检召回率超次优23.79个百分点
罕见病确诊为什么平均要拖5年以上?上海交通大学与新华医院团队在《自然》给出答案:DeepRare 多智能体系统,用大语言模型驱动 40 余种专业工具协同诊断,每 …
阅读全文 →
急诊AI临床决策支持为何越用越没人用?SHAKED多LLM系统4周前瞻评估:采纳率从68%跌至30%,班次每多1小时使用概率降28%
急诊不缺聪明的 AI,缺的是「能持续用下去」的 AI。以色列 Rambam 医疗中心联合梅奥诊所团队,在《Nature Medicine》发表 SHAKED …
阅读全文 →
医疗AI智能体到底先在哪落地?哈佛斯坦福证据地图:行政工作流先行、诊断仍在路上,医生从「执行」转向「监督」
当大家都在谈「AI 智能体要进医院」,一个更现实的问题是:它到底先在哪一步真正落地?哈佛医学院 Joseph C. Kvedar、斯坦福大学 Justin M. …
阅读全文 →
医疗AI智能体如何帮癌症患者更快找到临床试验?神经符号多智能体工作流前瞻匹配3804名患者,F1达0.82、筛选提速4倍
癌症患者能否进入合适的临床试验,往往卡在「入组筛选」这道既繁琐又费时的人工门槛上——全球肿瘤临床试验入组率长期不足5%。美国圣卢克大学健康网络与Massive …
阅读全文 →
肺癌放疗计划如何又快又好?LLM引导的模块化多智能体强化学习框架把临床目标达成率从74%提到98%、大模型调用省下75%
肺癌调强放疗(IMRT)计划是既精细又耗时的临床决策:既要给肿瘤足够剂量,又要保护肺、食管、脊髓等正常器官,往往需要物理师反复手工微调。美国西奈山伊坎医学院团队 …
阅读全文 →
眼科AI智能体如何让诊断「有据可查」?AgentEYE融合眼底彩照、B超与循证检索,盲评200例在正确性、完整性、安全性与可溯源性上全面超越纯大模型
眼科AI如何让每个诊断都有据可查?浙江大学眼科团队联合新加坡、美国、波兰学者在《Cell Reports Medicine》发表AgentEYE——一个可审计的 …
阅读全文 →
自主医疗AI智能体进入临床是敌是友?黄天荫团队厘清AAAS与聊天机器人边界,提出技术、人员、监管三层治理框架
自主医疗AI智能体(AAAS)既能回答问题也能动手执行任务,进入临床是敌是友?清华大学黄天荫团队在《柳叶刀·数字健康》发表评论,把医疗AI分成「LLM聊天机器 …
阅读全文 →
智能体定制开发怎么选外包?定制外包与平台工具的 4 个区别、6 个评估维度
智能体定制开发怎么选外包,先分清一件事:你要的是「定制外包」还是「平台工具」。前者是找团队做私有化、对接你业务系统的全案定制,后者是自己在低代码平台上搭一个公网 …
阅读全文 →
中轴型脊柱关节炎为何平均延误6.7年才确诊?解放军总医院×清华SpAgents四智能体协同系统以94%敏感性早筛并赋能基层
中轴型脊柱关节炎(axSpA)是一种以慢性腰背痛起病的风湿免疫病,全球平均诊断延迟高达 6.7 年,未经治疗者 3 年致残率 45%、5 年 70%。解放军总医 …
阅读全文 →
临床预测模型如何摆脱「医生看不懂的黑箱」?HACHI 人机协同框架让 AI 智能体与临床专家共创可解释模型,两个真实任务胜出、建模不到 8 小时
医疗 AI 在临床落地最大的坎,往往不是「准不准」,而是「医生信不信、看不看得懂」。加州大学旧金山分校 Jean Feng 团队在 npj Digital …
阅读全文 →
医疗AI智能体如何判断自己的诊断是否可信?用「行为一致性」替代模型置信度,筛出49.4%可自主处理的低风险病例
大语言模型驱动的自主临床 AI 智能体已经能独立完成问诊、开检查、下诊断的完整流程,可医院还是不敢让它们「上手」。德累斯顿工业大学 Kather 团队 2026 …
阅读全文 →
医院的知识散落在病历、指南和文献里怎么办?思陌医疗AI智能体定制用RAG知识问答,把私有知识变成随问随答、条条可溯源的医院AI助手
一、痛点:医院的知识为什么"查起来难" 医院最值钱的资产,往往不是设备,而是长期沉淀下来的知识。但这些知识是"散"的: …
阅读全文 →
医疗AI智能体如何真正进入医院门诊?清华AI-TEC六类多智能体重构眼科诊疗全流程,真实世界落地揭示数据质量比模型更关键
过去十年,医疗AI大多在回答同一个问题:机器能不能认出这张图?糖尿病视网膜病变分级、青光眼诊断、肺结节检测,榜单准确率一路刷到超过人类专家均值。可患者来医院是为 …
阅读全文 →
罕见神经内分泌肿瘤该用什么药?ARTEMIS 对比基础GPT、定制GPT与检索增强RAG三种配置,检索增强与定制GPT以70%专家一致率通过非劣效初探
医学AI在诊断端已经卷了很多年,但真正「拍板用药」的治疗决策,反而是公认最难啃、也最少人系统评估的环节。意大利多个医学中心在 npj Digital …
阅读全文 →
医疗AI智能体真比裸大模型更会看病吗?npj基准评测OpenManus/Manus发现准确率提升有限、成本却高出一个数量级
「智能体(Agent)」是当下医疗 AI 最热的关键词,宣传里它几乎成了大模型真正进临床的入场券。但一个更基本的问题很少有人系统回答:给大模型装上规划、工具调用 …
阅读全文 →
孕期并发症能否被提前预判?MoChiAgent 母子AI智能体整合440万次纵向就诊记录预测母婴疾病风险
全球每年有数十万孕产妇因并发症失去生命,数百万新生儿面临健康威胁。而传统孕期风险评估要么依赖医生个人经验,要么需要侵入性或有创检查,等胎盘早剥、子痫前期这类急重 …
阅读全文 →
医疗AI智能体如何从单次诊断走向长期疾病管理?谷歌AMIE双智能体架构在100例多访诊场景中治疗与检查精准度超越基层医生
过去几年,医疗大模型的能力评估几乎都集中在「诊断」上——给一段病史,让模型给出鉴别诊断。但真实临床里,诊断只是起点,医生真正花时间的是「管理推理」:判断疾病如何 …
阅读全文 →
远程问诊AI如何像医生一样看图问诊?谷歌多模态AMIE以状态感知框架在105场模拟会诊中29/32维度超越基层医生
真实远程问诊从来不是纯文字——患者会发皮疹照片、心电图截图、化验单和出院记录,医生要一边问病史、一边看图看检查、一边决定下一步追问。然而过去绝大多数医疗大模型的 …
阅读全文 →
外科共管患者筛选能否自动化?斯坦福 SCM Navigator 用大模型嵌入 EHR 实现 94% 敏感度的人机协同分诊
外科共管(Surgical Comanagement,SCM)是让内科医生与外科团队共同管理病情复杂围手术期患者的循证照护模式,能降低并发症与死亡率,却因长期依 …
阅读全文 →
急诊分诊如何在没有生命体征时先排危重队列?ED-Triage-Agent 双阶段多智能体协作方案
急诊分诊要在时间压力与信息不全下快速判断病情急迫度,但现有 AI 分诊系统必须拿到生命体征等完整数据才能预测,无法支撑真实分诊中「先有症状、后有体征」的序贯信息 …
阅读全文 →
肝脏恶性肿瘤为何总被漏诊?LiON 多中心 AI 诊断网络嵌入放射工作流,超万人前瞻试验 AUC 达 0.952
肝脏恶性肿瘤常在增强 CT 上评估,但高流量真实放射工作流中的漏诊与延迟诊断始终是难题。中国医科大学附属盛京医院联合浙江大学医学院附属第一医院、阿里巴巴达摩院等 …
阅读全文 →
急诊AI临床决策支持为何越用越没人用?SHAKED多LLM系统4周前瞻评估揭示采纳率从68%跌至30%
急诊被普遍视为AI临床决策支持最有价值的落地场景,但真正把系统装进急诊、让真实医生在真实班次里用的前瞻性证据一直稀缺。以色列Rambam医疗中心联合以色列理工学 …
阅读全文 →
急诊重症患者的谵妄为什么总被漏诊?大模型多学科智能体 DeLiriuMAgents 模拟三科会诊,跨三个数据库稳健预警
谵妄在急诊科发生率约 15%、在重症监护室高达约 32%,却因起病隐匿、临床节奏紧张而常被漏诊。 …
阅读全文 →
医疗 AI 智能体扛得住医院高峰期的混合任务洪峰吗?轻量编排多智能体靠任务级隔离守住 65.3% 准确率、省下 65 倍 token
医疗大模型的智能体叙事大多建立在一次只做一件事的评测上,但真实医院是检索、抽取、剂量计算等混合任务同时涌来的场景。西奈山伊坎医学院团队在 npj Health …
阅读全文 →
急诊科里医学知识与临床数据怎样自动协同?ED 自主智能体融合 80 万节点混合图谱,分诊准确率提升 23.13%
医学知识的积累与临床实践本应形成闭环,但在急诊科这类高压、快节奏场景下,让系统自动从动态数据中提炼新知、反过来指导实践,始终是一道难题。中山大学与广州医科大学等 …
阅读全文 →
AI 心理健康聊天机器人为何越聊越危险?SIM-VAIL 审计框架揭示风险随对话轮次累积的规律
越来越多人把情感与心理健康困扰倾诉给消费级 AI 聊天机器人,但它们真的安全吗?英国伦敦大学学院(UCL)团队在《Nature Medicine》 …
阅读全文 →
医疗AI智能体真比裸大模型更会看病吗?OpenManus 与 Manus 临床决策基准评测的审慎结论
给大模型配上工具、让它在临床任务里自主规划,就真的更会看病吗?中国医学科学院肿瘤医院联合德国德累斯顿工业大学在《npj Digital Medicine》发布的 …
阅读全文 →
远程医疗AI会误诊、开错药吗?MedGuard 声明级风险守门员为中文线上问诊装上安全闸
厦门大学联合蚂蚁集团、湖南大学在《npj Digital Medicine》发表首个专门为中文远程医疗站岗的 LLM 智能体 MedGuard。它把医患对话拆成 …
阅读全文 →
生成式AI临床决策支持真能改善患者结局吗?AI Consult 在肯尼亚16家基层诊所近万例患者中的务实整群随机试验给出诚实答案
由伯明翰大学、伦敦卫生与热带医学院(LSHTM)与 KEMRI-Wellcome Trust 联合团队在《Nature Medicine》发表的务实整群随机试 …
阅读全文 →
中轴型脊柱关节炎如何突破 6.7 年诊断延迟?解放军总医院×清华 SpAgents 四智能体协同系统实现 94% 敏感性早筛并赋能基层
解放军总医院(第一医学中心)风湿免疫科联合清华大学自动化系生物信息学团队,在《npj Digital Medicine》发表 SpAgents——一套基于多智能 …
阅读全文 →
临床笔记里的认知障碍如何被 AI 智能体自主发现?麻省总医院布里格姆五智能体工作流 Pythia 以 98% 特异度实现无人工干预筛查并开源
麻省总医院布里格姆(Mass General Brigham)Tian、Estiri、Moura 等人在《npj Digital Medicine》发表一项研 …
阅读全文 →
医疗AI智能体如何安全地融入临床工作流?MedAgentBrief agentic 工作流生成低危害住院小结并显著降低医生职业倦怠
斯坦福大学医学院 François Grolleau、陈俊华(Jason H. Chen)等人在《JAMA Network Open》发表一项单臂前瞻性质量改进 …
阅读全文 →
AI 智能体进病理科到底该干什么?UPMC 用 94 例活检验证『受约束报告智能体』:出报告耗时近乎减半、未见诊断幻觉
美国匹兹堡大学医学中心(UPMC)Ibrahim Abukhiran 与 Liron Pantanowitz 团队在《Modern Pathology》发表首个 …
阅读全文 →
病理 AI 如何从『预测工具』进化为『科学发现引擎』?SPARK 多智能体框架让 AI 自主提出并验证肿瘤生物学假说
德国科隆大学医院病理研究所 Yuri Tolkach 团队在 Nature Medicine 发表 SPARK(System of Pathology …
阅读全文 →
医疗影像智能体该让大模型直接看图吗?AgentEYE 用专科工具加循证检索把眼科诊断正确性从 36.5 分提到 71.9 分
浙江大学医学院附属第二医院眼科中心金凯团队联合新加坡、美国、波兰等机构在 Cell Reports Medicine 发表 AgentEYE,一个自动完成影像模 …
阅读全文 →
医疗智能体的知识库怎么建、怎么持续更新?MedKGent 双智能体框架从1000万篇文献生成297万条三元组
穆罕默德·本·扎耶德人工智能大学联合中科院、清华、哈佛医学院等机构提出 MedKGent,用 Extractor 与 Constructor 两个智能体逐日增量 …
阅读全文 →
胸片AI模型各管一段、结论互相打架怎么整合?RadFabric 用 MCP 编排 16 个智能体,MIMIC-CXR 上 AUC 85.18%
香港城市大学、麻省总医院与佐治亚大学等机构提出 RadFabric,基于 Model Context Protocol 编排 16 个专用智能体完成胸片诊 …
阅读全文 →
通用大模型如何胜任房颤慢病管理?PULSE 智能体框架以知识增强+双模型自一致实现四模型全面提优
蚌埠医科大学联合多家医院提出 PULSE 智能体框架,通过房颤专科知识库+双模型自一致机制, …
阅读全文 →
AI做第一意见还是第二意见?斯坦福随机对照试验揭示人机协作诊断的最优模式
斯坦福大学联合哈佛医学院等多家机构,通过70位临床医师参与的随机对照试验,首次系统比较了AI作为第一意见和第二意见两种协作模式。结果显示,AI先独立分析、再与医 …
阅读全文 →
罕见病诊断如何突破5年等待?DeepRare多智能体系统首诊准确率64.4%超越资深医师
上海交大与新华医院联合团队在Nature发表DeepRare,一个集成40+专用工具的多智能体罕见病诊断系统。在2,919种疾病上首诊准确率达64.4%超越5位 …
阅读全文 →
HemaGuide:两千例真实病例记忆驱动的AI智能体实现血液肿瘤决策一致率82.8%,幻觉率仅0.3%
一、研究背景 血液恶性肿瘤的治疗决策是临床医学中最复杂的场景之一。医生不仅需要判断疾病实体和分期,还必须综合细胞遗传学异常、分子突变特征、患者合并症、既往治疗毒 …
阅读全文 →
五位AI专家组成虚拟科研团队:多智能体协作将临床试验设计从数周压缩至数分钟
一、研究背景 随机对照试验(RCT)是评估医疗干预安全性与有效性的金标准,但设计一份完整的临床试验方案,往往需要临床医生、统计学家、医学信息学专家和研究协调员持 …
阅读全文 →
医生与AI评估LLM临床能力存在系统性分歧:400+医生7专科多中心研究揭示评估标准不可互换
北京友谊医院联合国内外17家机构开展迄今最大规模LLM临床评估研究,揭示医生与AI评估者之间存在系统性认知分歧——AI将OpenAI o1排为第一,而医生更青 …
阅读全文 →
NEJM Catalyst:放射科随访AI智能体"闭环"系统发现6.18倍漏诊,97%准确率已投入真实临床运行12万+例
一、研究背景 诊断延误(missed diagnostic opportunities)是患者安全事故最常见的类型之一。美国国家医学院(原IOM)早在2015 …
阅读全文 →
Pathology-CoT:从专家阅片行为中学习"视觉思维链",病理AI智能体自主诊断性能超越GPT-o3
一、研究背景 数字病理学是AI辅助诊断最早也最成熟的领域之一。从2017年Google的淋巴结转移检测算法登上JAMA,到近年自监督病理基础模型( …
阅读全文 →
【今日医疗AI速递】WiseMind:多智能体框架首次在精神科对话诊断中实现"情理兼备",准确率达85.6%逼近专家水平
一、研究��景 精神科诊断是临床医学中最具挑战性的任务之一。医生需要在有限时间内综合患者的言语症状史、行为观察和情境因素,在维护共情关系的同时完成复杂的鉴别诊 …
阅读全文 →
【今日医疗AI速递】Nature Medicine RCT:谷歌AMIE辅助心内科医生,临床显著错误减少近半,遗漏率降低过半
一、研究背景 心血管疾病是全球最主要的死亡原因之一,而亚专科心脏病学专家的严重短缺进一步加剧了诊疗可及性的困境。以遗传性心肌病为例,美国超过一半的州没有肥厚型 …
阅读全文 →
Retina4IRD:上海交大孙晓东团队Nature Medicine AI系统,将遗传性视网膜病基因诊断准确率从67.3%提升至88.5%
遗传性视网膜疾病(IRD)是儿童和青壮年不可逆失明的首要病因,全球患者超过500万,涉及300多个致病基因。然而,精准的基因诊断却是一道难以跨越的鸿沟——流程复 …
阅读全文 →
【今日医疗AI速递】Nature子刊:中科院DxDirector-7B仅70亿参数实现自主全流程临床诊断,准确率超越百倍参数大模型
一、研究背景 临床诊断的本质从来不是一道"给定全部信息后二选一"的选择题。真实世界里,医生面对的是患者模糊的主诉——“我最近总 …
阅读全文 →
医院AI智能体落地困局:展厅里的「神童」,科室里的「摆设」
问题:从CHIMA展会回到办公室,冰火两重天 刚参加完CHIMA展会,脑子还热着,想着这次总算能给门诊找个减负神器。结果回到办公室打开预算表一看,今年有钱的还是 …
阅读全文 →
【今日医疗AI速递】Lancet子刊:多智能体AI精准模拟肝移植委员会决策,禁忌症识别准确率达98%
一、研究背景 在医学的众多领域中,器官移植是唯一一个"治疗手段明确定量配给"的特殊领域。以肝移植为例,美国终末期肝病患者中仅5%~10%能 …
阅读全文 →
【今日医疗AI速递】Nature重磅:自主AI智能体MIRA在急诊诊断中全面超越医生,零安全事故
一、研究背景 大语言模型(LLM)在临床问答、影像报告生成等单点任务上已展现出不俗的表现,但这类应用本质上仍是"聊天机器人"——它们能给出 …
阅读全文 →
【今日医疗AI速递】Nature Medicine:AI眼底扫描精准锁定致病基因,多中心RCT证实诊断准确率提升21%
一、研究背景 遗传性视网膜疾病(Inherited Retinal Diseases, IRD)是导致儿童和劳动年龄人群失明的主要原因之一。这类疾病由超 …
阅读全文 →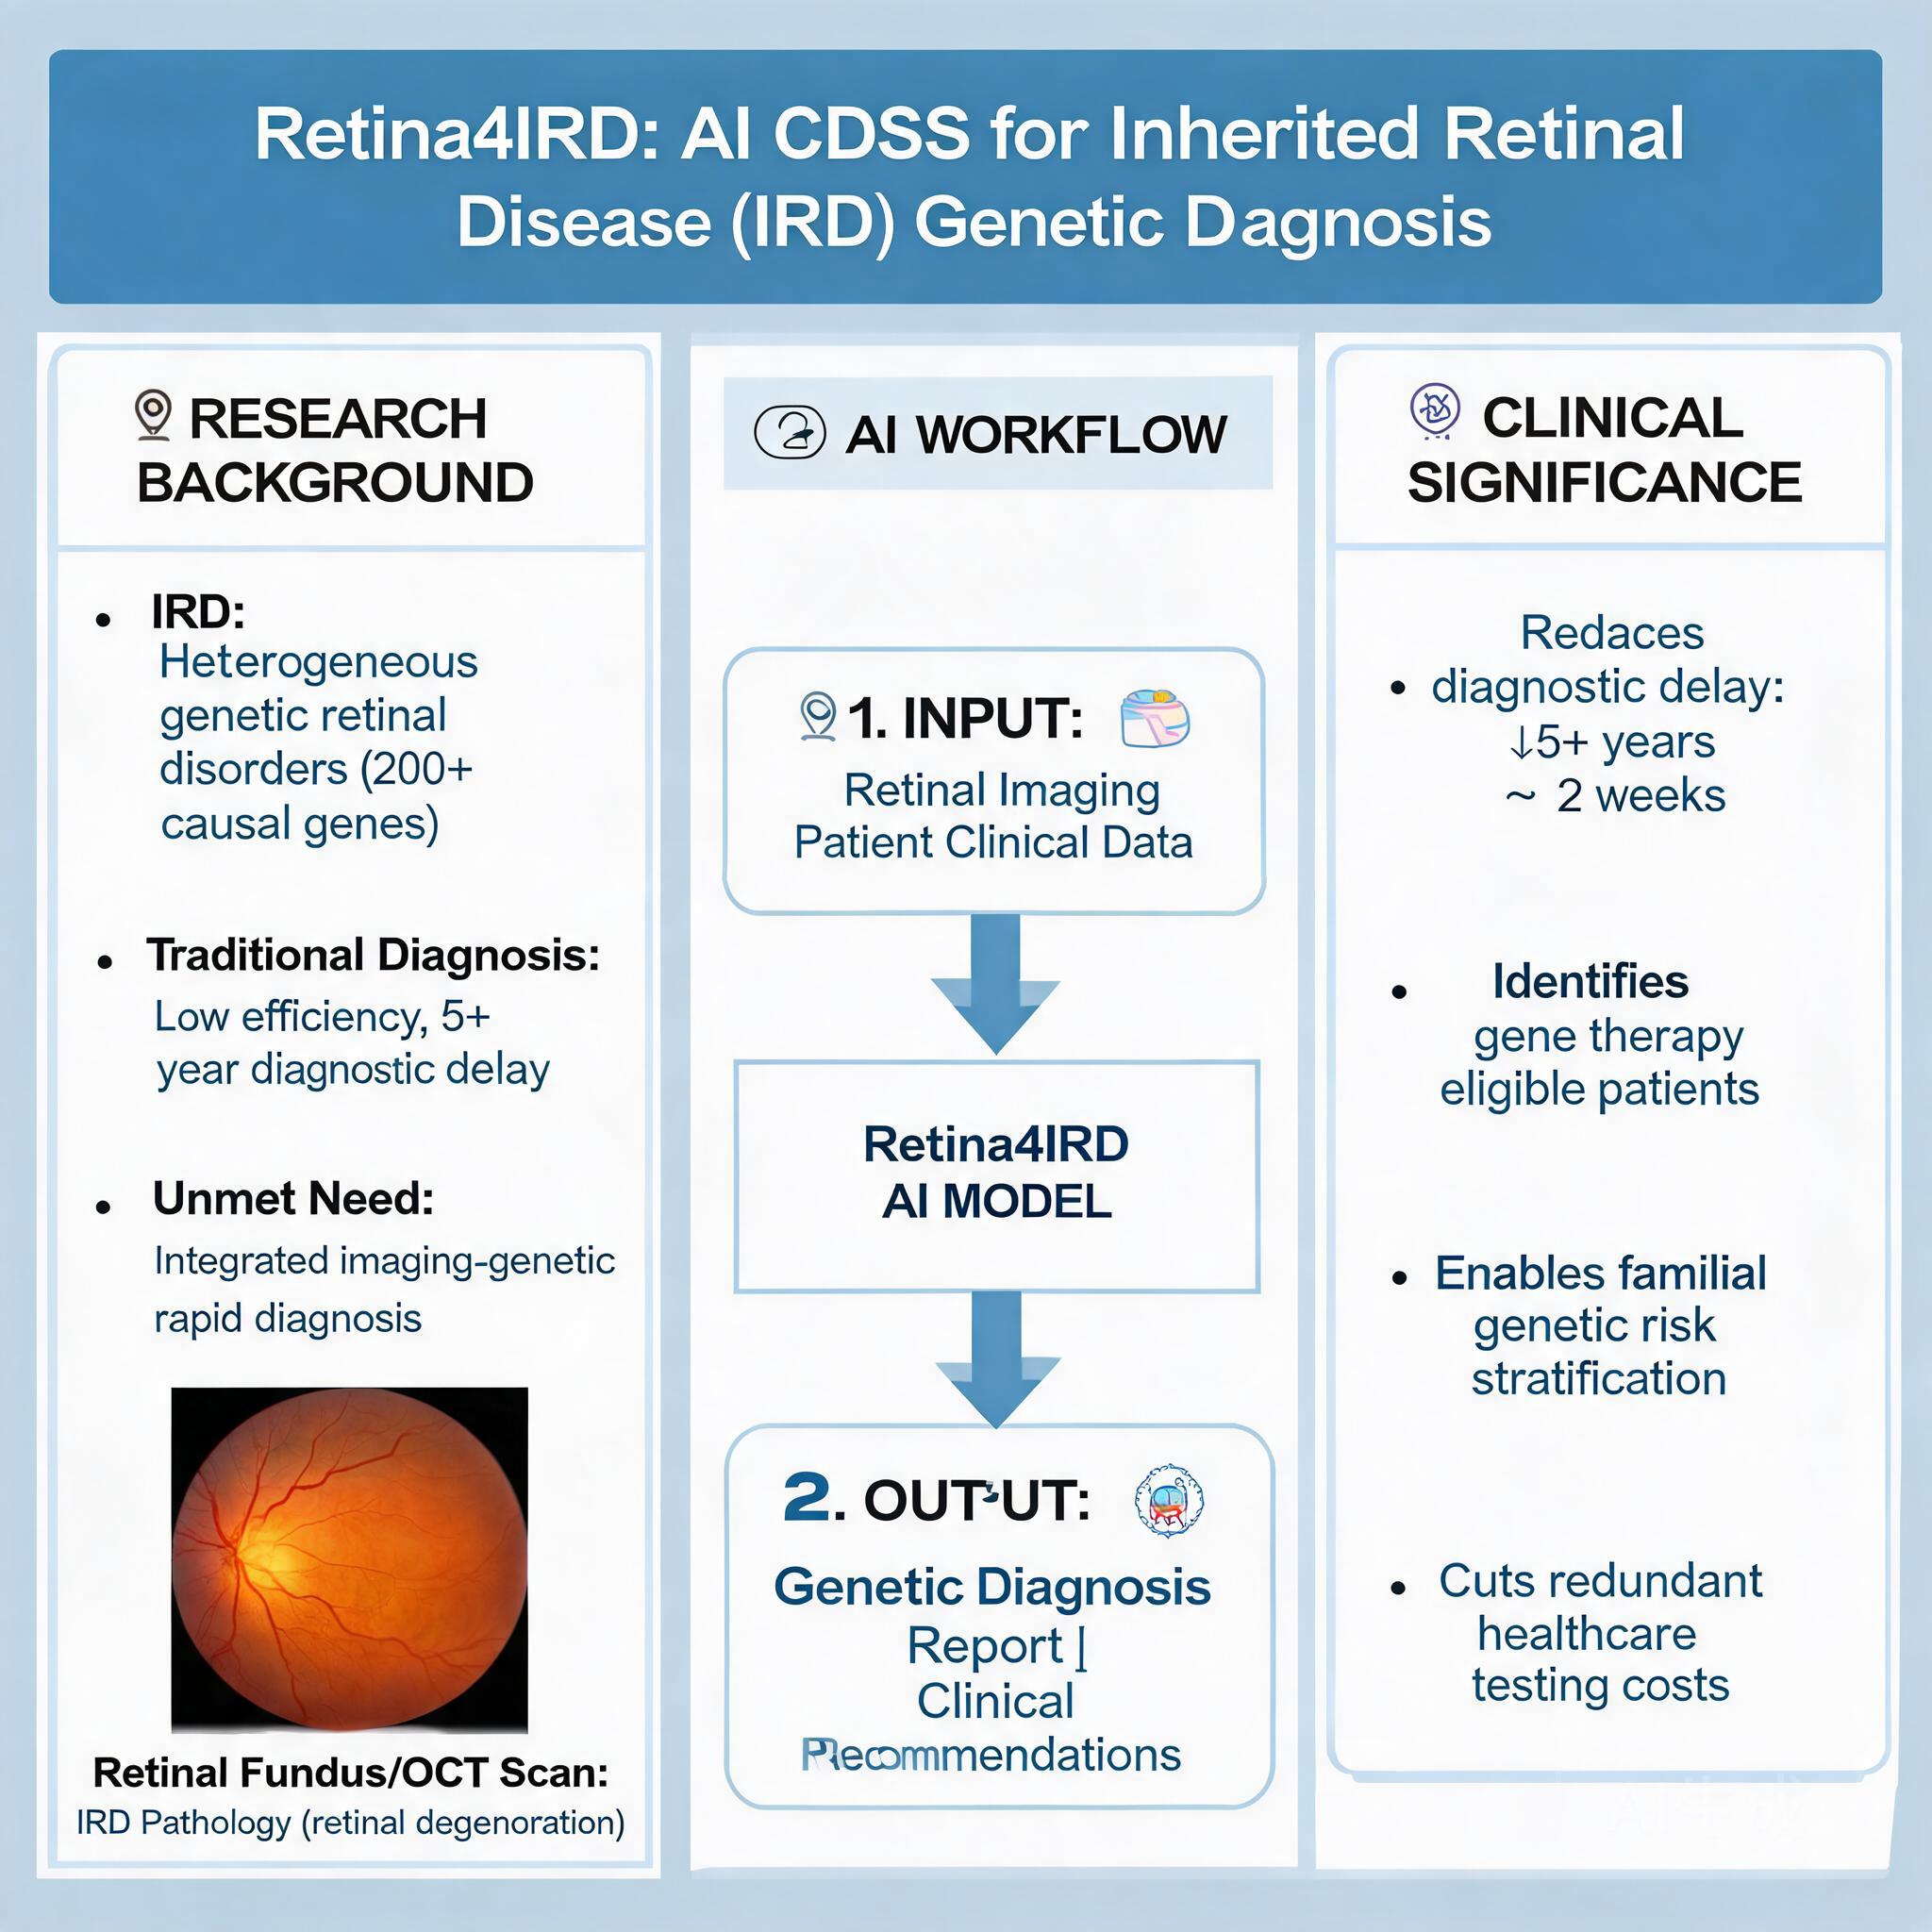
2026年医疗AI五大趋势:从诊室到实验室的智能革命
趋势一:大模型从"演示"走向"诊疗" 2026年上半年,国内已有超过30家三甲医院正式将大模型接入临床工作流。不同于此前 …
阅读全文 →