
医疗AI智能体如何帮癌症患者更快找到临床试验?神经符号多智能体工作流前瞻匹配3804名患者,F1达0.82、筛选提速4倍
肿瘤临床试验入组率为何长期不足5%?美国圣卢克大学健康网络与Massive Bio团队在《ESMO真实世界数据与数字肿瘤学》发表神经符号多智能体AI平台,前瞻匹配3804名患者,F1达0.82、远超裸大模型,筛选时间从120分钟压到约30分钟。
研究背景:为什么肿瘤临床试验入组率长期不足 5%?
对很多晚期或进展期癌症患者来说,临床试验可能是最后的治疗希望。但全球范围内,真正能进入临床试验的合格成人患者不足 5%,远不是「没有试验可做」,而是卡在入组这道门槛上。
问题的根源在于入组筛选太复杂、太耗人力。一条临床试验的入排标准动辄几十上百条,涉及基因突变、既往治疗、器官功能、分期分型等,散落在病历、影像、病理、分子检测报告里。医生要手动把这些信息一条条对照,平均每个患者要花约 120 分钟才能完成一轮筛选,既慢又容易漏。
近年来,大语言模型(LLM)被尝试用来做试验匹配,但纯 LLM 直接问答的效果并不理想:它容易「记不住」海量入排细则,也缺乏对「某条标准是否满足」的确定性判断。
2026 年 4 月 7 日,美国圣卢克大学健康网络(St. Luke’s University Health Network)与 Massive Bio 团队在《ESMO Real World Data and Digital Oncology》在线发表论文,提出一套 神经符号 + 多智能体的 AI 平台,正是冲着这道坎来的。
创新点:医疗多智能体工作流如何「四件套」协同匹配?
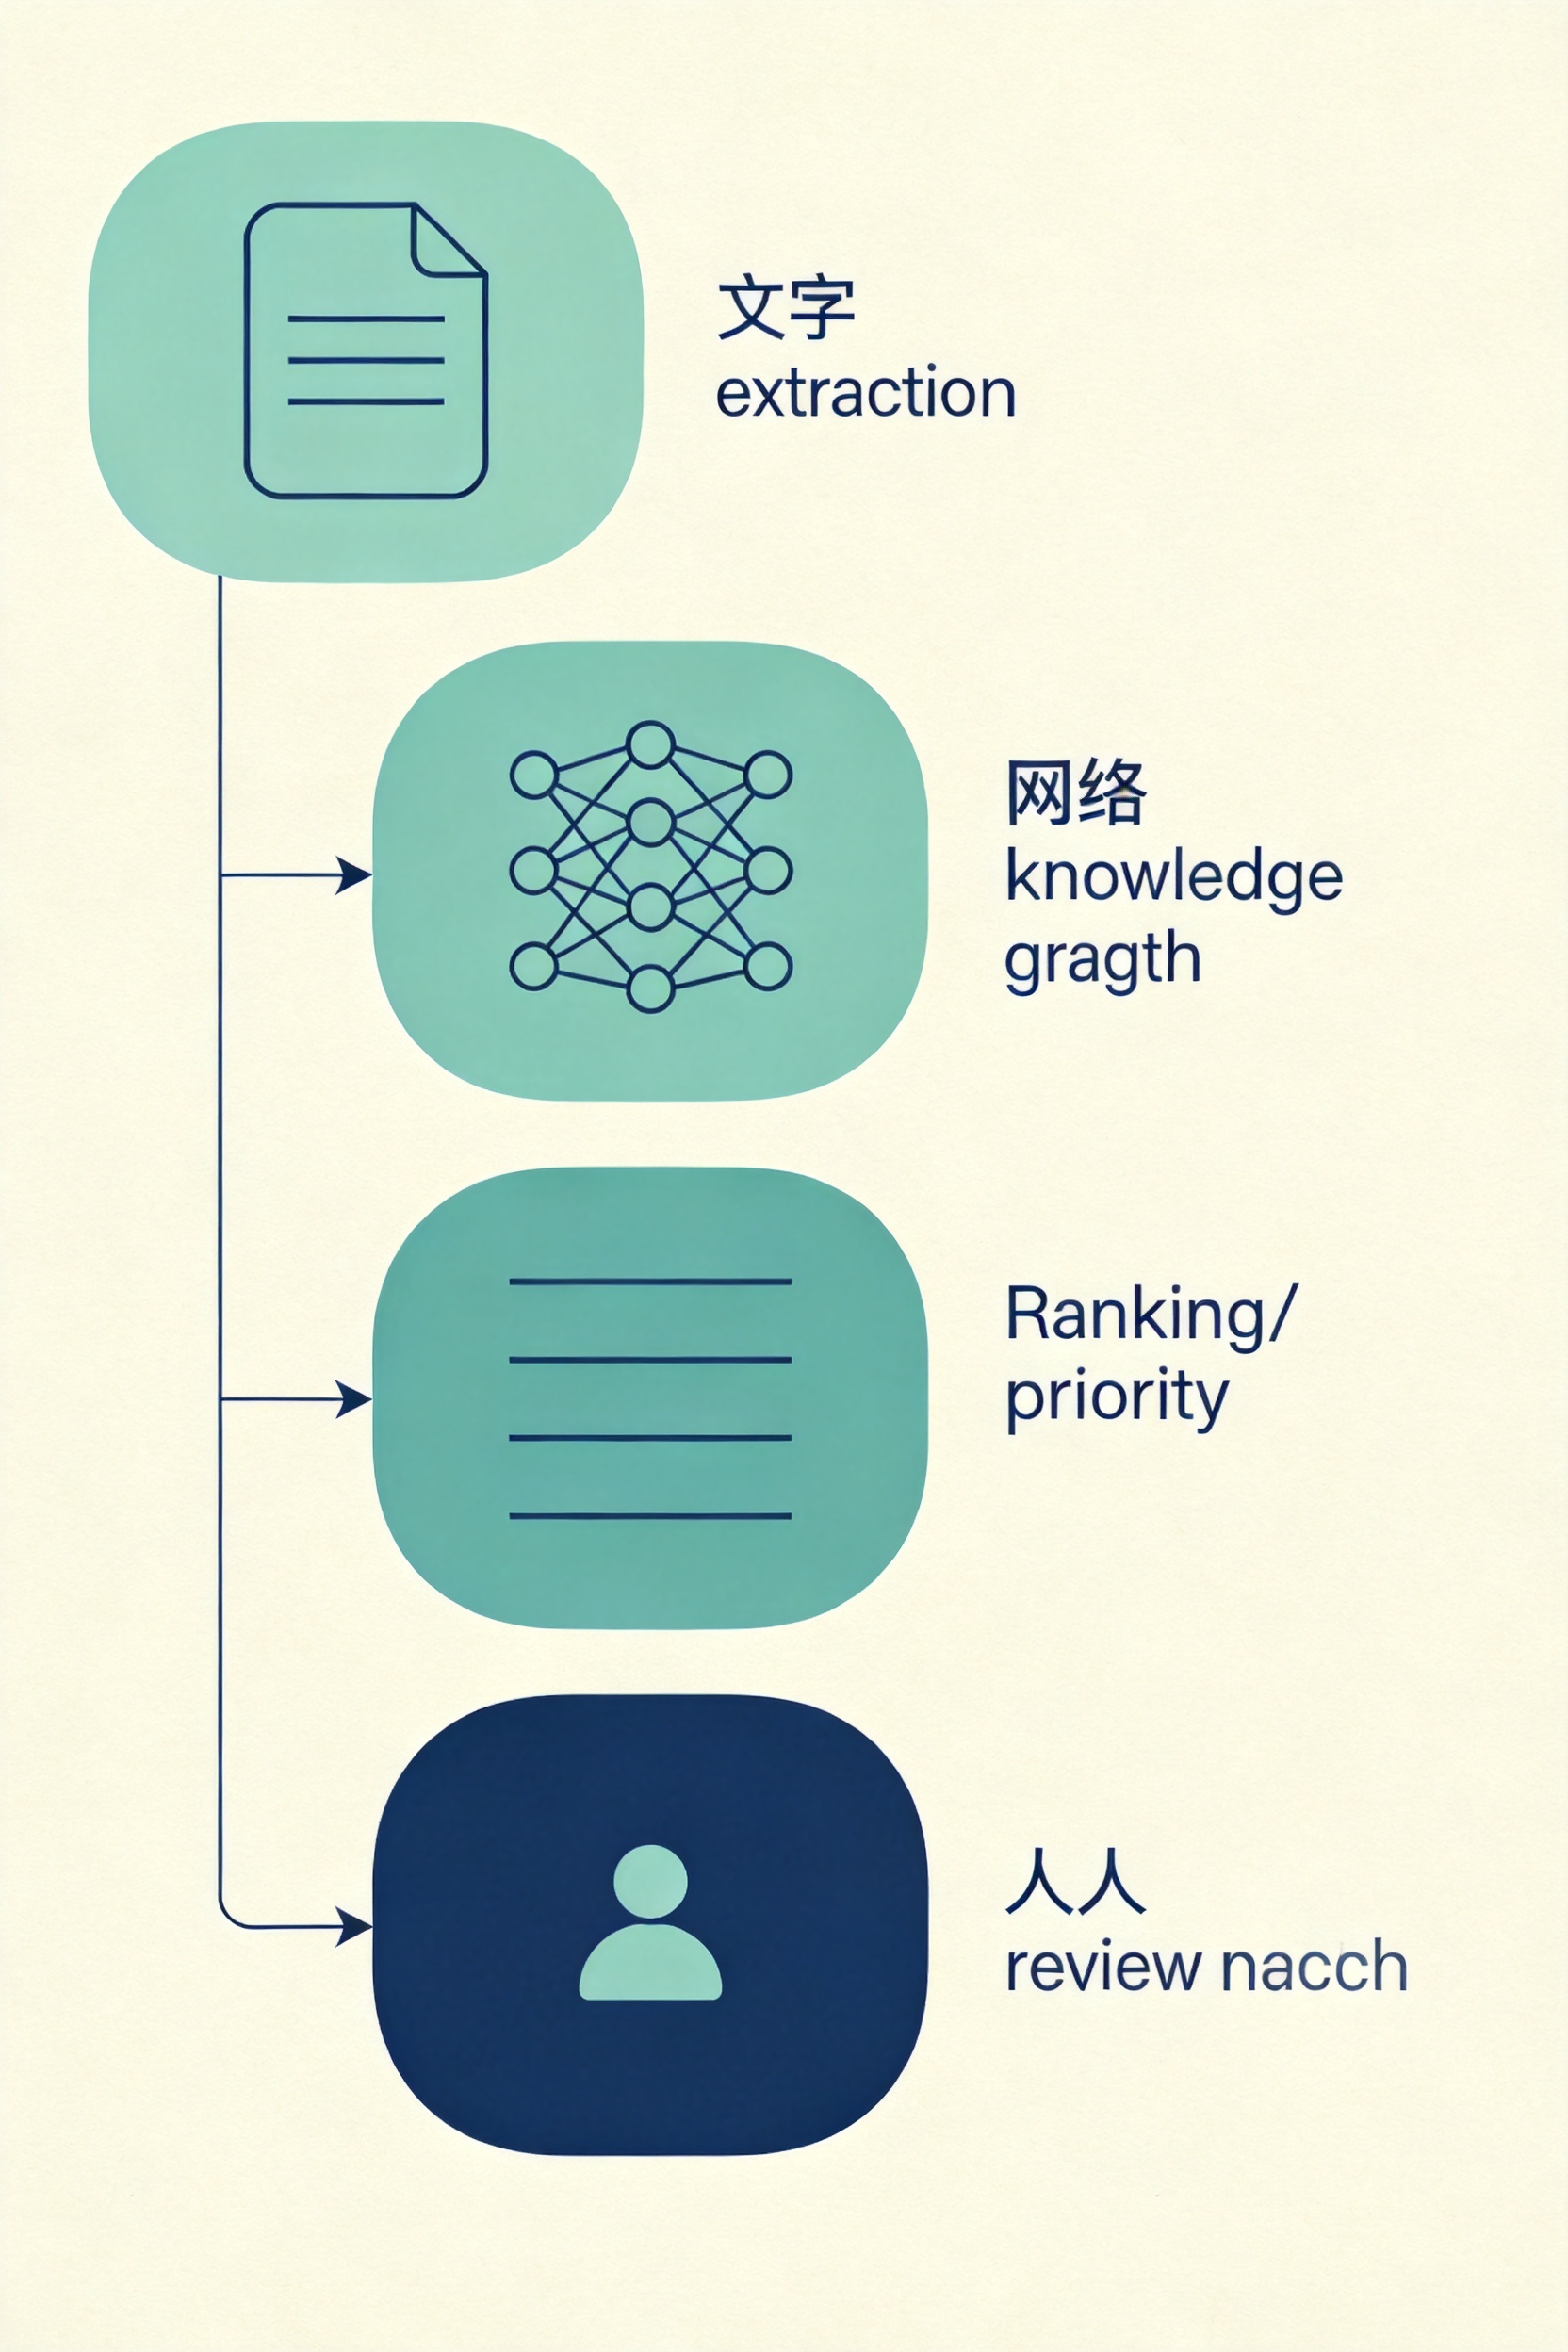
这套平台不再是「一个模型包打天下」,而是由四个组件组成的医疗多智能体工作流,各司其职:
- OncoAgents(提取与推理智能体):负责从非结构化的临床文本里自动抽取患者信息,并进行推理;
- OncoGraph(肿瘤知识图谱):把入排标准、药物、靶点、分期等知识结构化,提供确定性的推理「底座」;
- OncoRecommend(优先级引擎):对候选试验做实时排序,优先推荐更合适的试验;
- OncoSet(专家精编语料库):由肿瘤专家整理的高质量参考语料,用于校准与兜底。
最关键的一点是,它引入了人机协作(human-in-the-loop):AI 只负责「抽取、对齐、初筛」,最终是否入组仍由肿瘤医生复核确认。这与「让 AI 直接替患者做决定」的激进路线划清了界限。
技术原理:神经符号 = 大模型提取 + 知识图谱确定性推理
这套系统的技术内核,是「神经符号 AI」——把两种互补的能力拼在一起:
- 神经侧(大模型):擅长「读懂」杂乱、残缺、异构的病历文本,把自然语言里的信息抽出来、对齐到统一字段;
- 符号侧(知识图谱 + 确定性规则):擅长「算准」某条入排标准到底满不满足,给出可审计、可回溯的结论。
换句话说,这个「临床决策智能体」用大模型解决「信息从哪里来」,再用知识图谱解决「规则怎么算」。作者在消融实验里发现,知识图谱的锚定(grounding)和多智能体的任务拆分,都对准确率和效率有实质贡献——少了任何一环,表现都会明显下滑。
数据说话:F1 达 0.82,筛选时间压缩 4 倍
研究在 12 个月内前瞻性筛选了 3804 名符合条件的癌症患者(ECOG 评分 0–2,转移或进展期恶性肿瘤),共处理 157,367 页临床资料(约 8650 万 token),筛选了 23,912 个「患者—试验」候选对,最终产出 17,912 个经肿瘤医生确认的匹配。
| 指标 | 神经符号多智能体 | GPT-4 零样本 | GPT-4 思维链 |
|---|---|---|---|
| F1 分数 | 0.82(95%CI 0.81–0.83) | 0.47 | 0.67 |
| 敏感性 | 0.8375 | — | — |
| 特异性 | 0.8359 | — | — |
| 精确率 | 0.8121 | — | — |
在效率上,每名患者的筛选时间从手动约 120 分钟压缩到约 30 分钟(15 分钟自动处理 + 15 分钟临床复核),提速约 4 倍;中位「从筛选到给出推荐」的时间不到 7 天。
公平性方面,没有任何人口学亚组的 F1 差距超过 10 个百分点,最大的差异约 7 个点(白人与黑人/非裔患者之间),说明这套系统没有因人群不同而出现严重的性能分化。
应用前景与局限
这篇论文最大的价值,是它用前瞻性、大规模、真实世界数据回答了一个务实的问题:AI 智能体到底能不能帮医生把「入组筛选」这件事做得又快又准。
- 它证明了「大模型 + 知识图谱」的组合,比单纯堆大模型更可靠、也更可审计;
- 它给出了一条可落地的「人机协同」路径:AI 做初筛,医生做最终确认,安全边界清晰。
但局限同样明确:研究来自单一卫生网络(美国圣卢克大学健康网络),患者群体和病历系统相对集中,跨机构、跨国家的泛化性仍需验证;此外,它衡量的是「匹配准确率与效率」,并未直接证明能否提高真实入组率或改善患者生存结局,这些还需前瞻性随机对照研究来回答。
结论
这篇论文给出的信号很清晰:在「入组筛选」这类规则密集、数据异构的临床工作流里,神经符号多智能体比裸大模型明显更靠谱——F1 从 0.47 拉到 0.82,筛选时间砍掉四分之三,还守住了公平性。
对正在构建医疗多智能体工作流的团队来说,它再次印证了一个判断:智能体的竞争力,不在「模型有多强」,而在「把模型的能力和领域知识、确定性规则正确组合起来」。
| 论文标题 | Transforming oncology clinical trial matching through neuro-symbolic, multi-agent AI and an oncology-specific knowledge graph: a prospective evaluation in 3804 patients(神经符号多智能体AI与肿瘤知识图谱驱动肿瘤临床试验匹配:3804名患者的前瞻性评估) |
| 作者 | A. Loaiza-Bonilla、C. Yost、S. Kurnaz、E. Tuysuz、N.G. Thaker、D. Giritlioglu、J.P. Noel Meza;通讯作者:Arturo Loaiza-Bonilla |
| 机构 | 美国圣卢克大学健康网络(St. Luke's University Health Network,宾夕法尼亚州伊斯顿)、Massive Bio Inc(佛罗里达州博卡拉顿)、克莱顿大学医学院(Creighton University,凤凰城)、Capital Health(宾夕法尼亚州彭宁顿) |
| 期刊 | ESMO Real World Data and Digital Oncology(《ESMO真实世界数据与数字肿瘤学》,欧洲肿瘤内科学会官方期刊) |
| 发表时间 | 2026 年 4 月 7 日在线发表 |
| DOI | 10.1016/j.esmorw.2026.100706 |
| PubMed | PMID 42004487 |
论文原文信息地址:https://www.simoagent.com/blog/2026-09-30-neurosymbolic-multiagent-trial-matching/
参考文献
- Loaiza-Bonilla A, Yost C, Kurnaz S, Tuysuz E, Thaker NG, Giritlioglu D, Noel Meza JP. Transforming oncology clinical trial matching through neuro-symbolic, multi-agent AI and an oncology-specific knowledge graph: a prospective evaluation in 3804 patients. ESMO Real World Data and Digital Oncology, 2026;12:100706. DOI: 10.1016/j.esmorw.2026.100706
相关问题
医疗智能体怎么做?
医疗智能体不是「一个模型一问答」,而是把一条临床工作流拆成多个分工明确的组件,再串起来协同完成。以这篇论文为例,它用「提取与推理智能体」抽取病历信息、「肿瘤知识图谱」做确定性推理、「优先级引擎」排序推荐、「专家语料库」兜底校准,并保留医生做最终复核——这种「神经侧理解 + 符号侧算准 + 人机协同」的组合,就是构建临床智能体的典型做法。
为什么「神经符号 + 多智能体」比裸大模型更强?
因为纯大模型做试验匹配有两个短板:一是难记住海量入排细则、容易漏判;二是缺乏「某条标准到底满不满足」的确定性判断。神经符号方法让大模型只负责「读懂文本、抽取信息」,把「规则怎么算」交给知识图谱的确定性推理;多智能体再把任务拆分,各自专注。二者叠加,让 F1 从裸大模型的 0.47 提升到 0.82。
这套系统能直接替医生做入组决定吗?
不能,也无意如此。论文明确采用「人机协作」设计:AI 只负责自动抽取、对齐、初筛和推荐,最终是否入组仍由肿瘤医生复核确认。研究衡量的是「匹配准确率与效率」,并未证明能提高真实入组率或改善生存结局,且数据来自单一卫生网络,跨机构泛化性仍需前瞻性随机对照研究进一步验证。