
肺癌放疗计划如何又快又好?LLM引导的模块化多智能体强化学习框架把临床目标达成率从74%提到98%、大模型调用省下75%
肺癌调强放疗计划为何又慢又难调?美国西奈山伊坎医学院放射肿瘤科团队在《国际放射肿瘤学·生物学·物理学杂志》发表LLM引导的模块化多智能体强化学习框架,让临床目标达成率从74%提到98%,肺保护模式下V20与平均肺剂量显著下降,且大模型调用次数省下75%。
研究背景:肺癌放疗计划为什么「又慢又难调」?
放疗是肺癌(尤其是无法手术的局部晚期非小细胞肺癌)的关键治疗手段之一,核心是调强放疗(IMRT)计划——把高剂量精确「打」到肿瘤上,同时尽量避开肺、食管、脊髓这些正常器官。
但做出一份合格的放疗计划,本质是一道多目标权衡的临床决策题:剂量给多了伤正常器官,给少了杀不干净肿瘤,还要满足每家医院自己的剂量约束标准。传统做法是「知识库规划(KBP)」,它虽能给出初始计划,却往往需要物理师反复手工微调才能达标,既慢又依赖个人经验。
近年来,大语言模型(LLM)和强化学习(RL)都被引入做自动计划,但各有短板:纯 LLM 缺乏对长期剂量优化的整体把控,纯 RL 又难以规模化扩展。如何把两者的长处结合起来,是放疗计划自动化要过的坎。
2026 年 9 月 17 日,美国纽约西奈山伊坎医学院放射肿瘤科团队(通讯作者 Jiahan Zhang)在《International Journal of Radiation OncologyBiologyPhysics》(俗称「红皮杂志」,ASTRO 会刊)在线发表论文,提出一个 LLM 引导的模块化多智能体强化学习框架,正是冲着这道坎来的。
创新点:医疗多智能体工作流如何「分层分工」?
这套框架的核心思路,是把「该由谁来做决定」这件事拆清楚——LLM 负责宏观调度与监督,强化学习智能体负责微观剂量微调,各司其职,组成一条清晰的医疗多智能体工作流:
- 两层分层架构:上层是一个 LLM 监督层,包含「规划者(Planner)」「评估者(Evaluator)」「监督者(Supervisor)」三个智能体;下层是一群执行具体剂量修改的任务型 RL 智能体;
- 模块化器官智能体:针对每个需要保护的正常器官(OAR)配备并行或串行的 RL 智能体,用 SARSA + 线性函数近似训练;
- 类别级权重共享:同一类器官共享权重,让智能体只用极少的训练样本就能泛化到其他器官,解决了 RL 难以规模化的问题。
换句话说,它不再让一个通用大模型「包揽每一步」,而是让大模型「管大局、做判断」,把重复性的剂量微调交给更擅长的 RL 智能体——这是它和纯 LLM 自动计划最本质的区别。
技术原理:临床决策智能体「LLM 管大局、RL 管执行」的两层架构
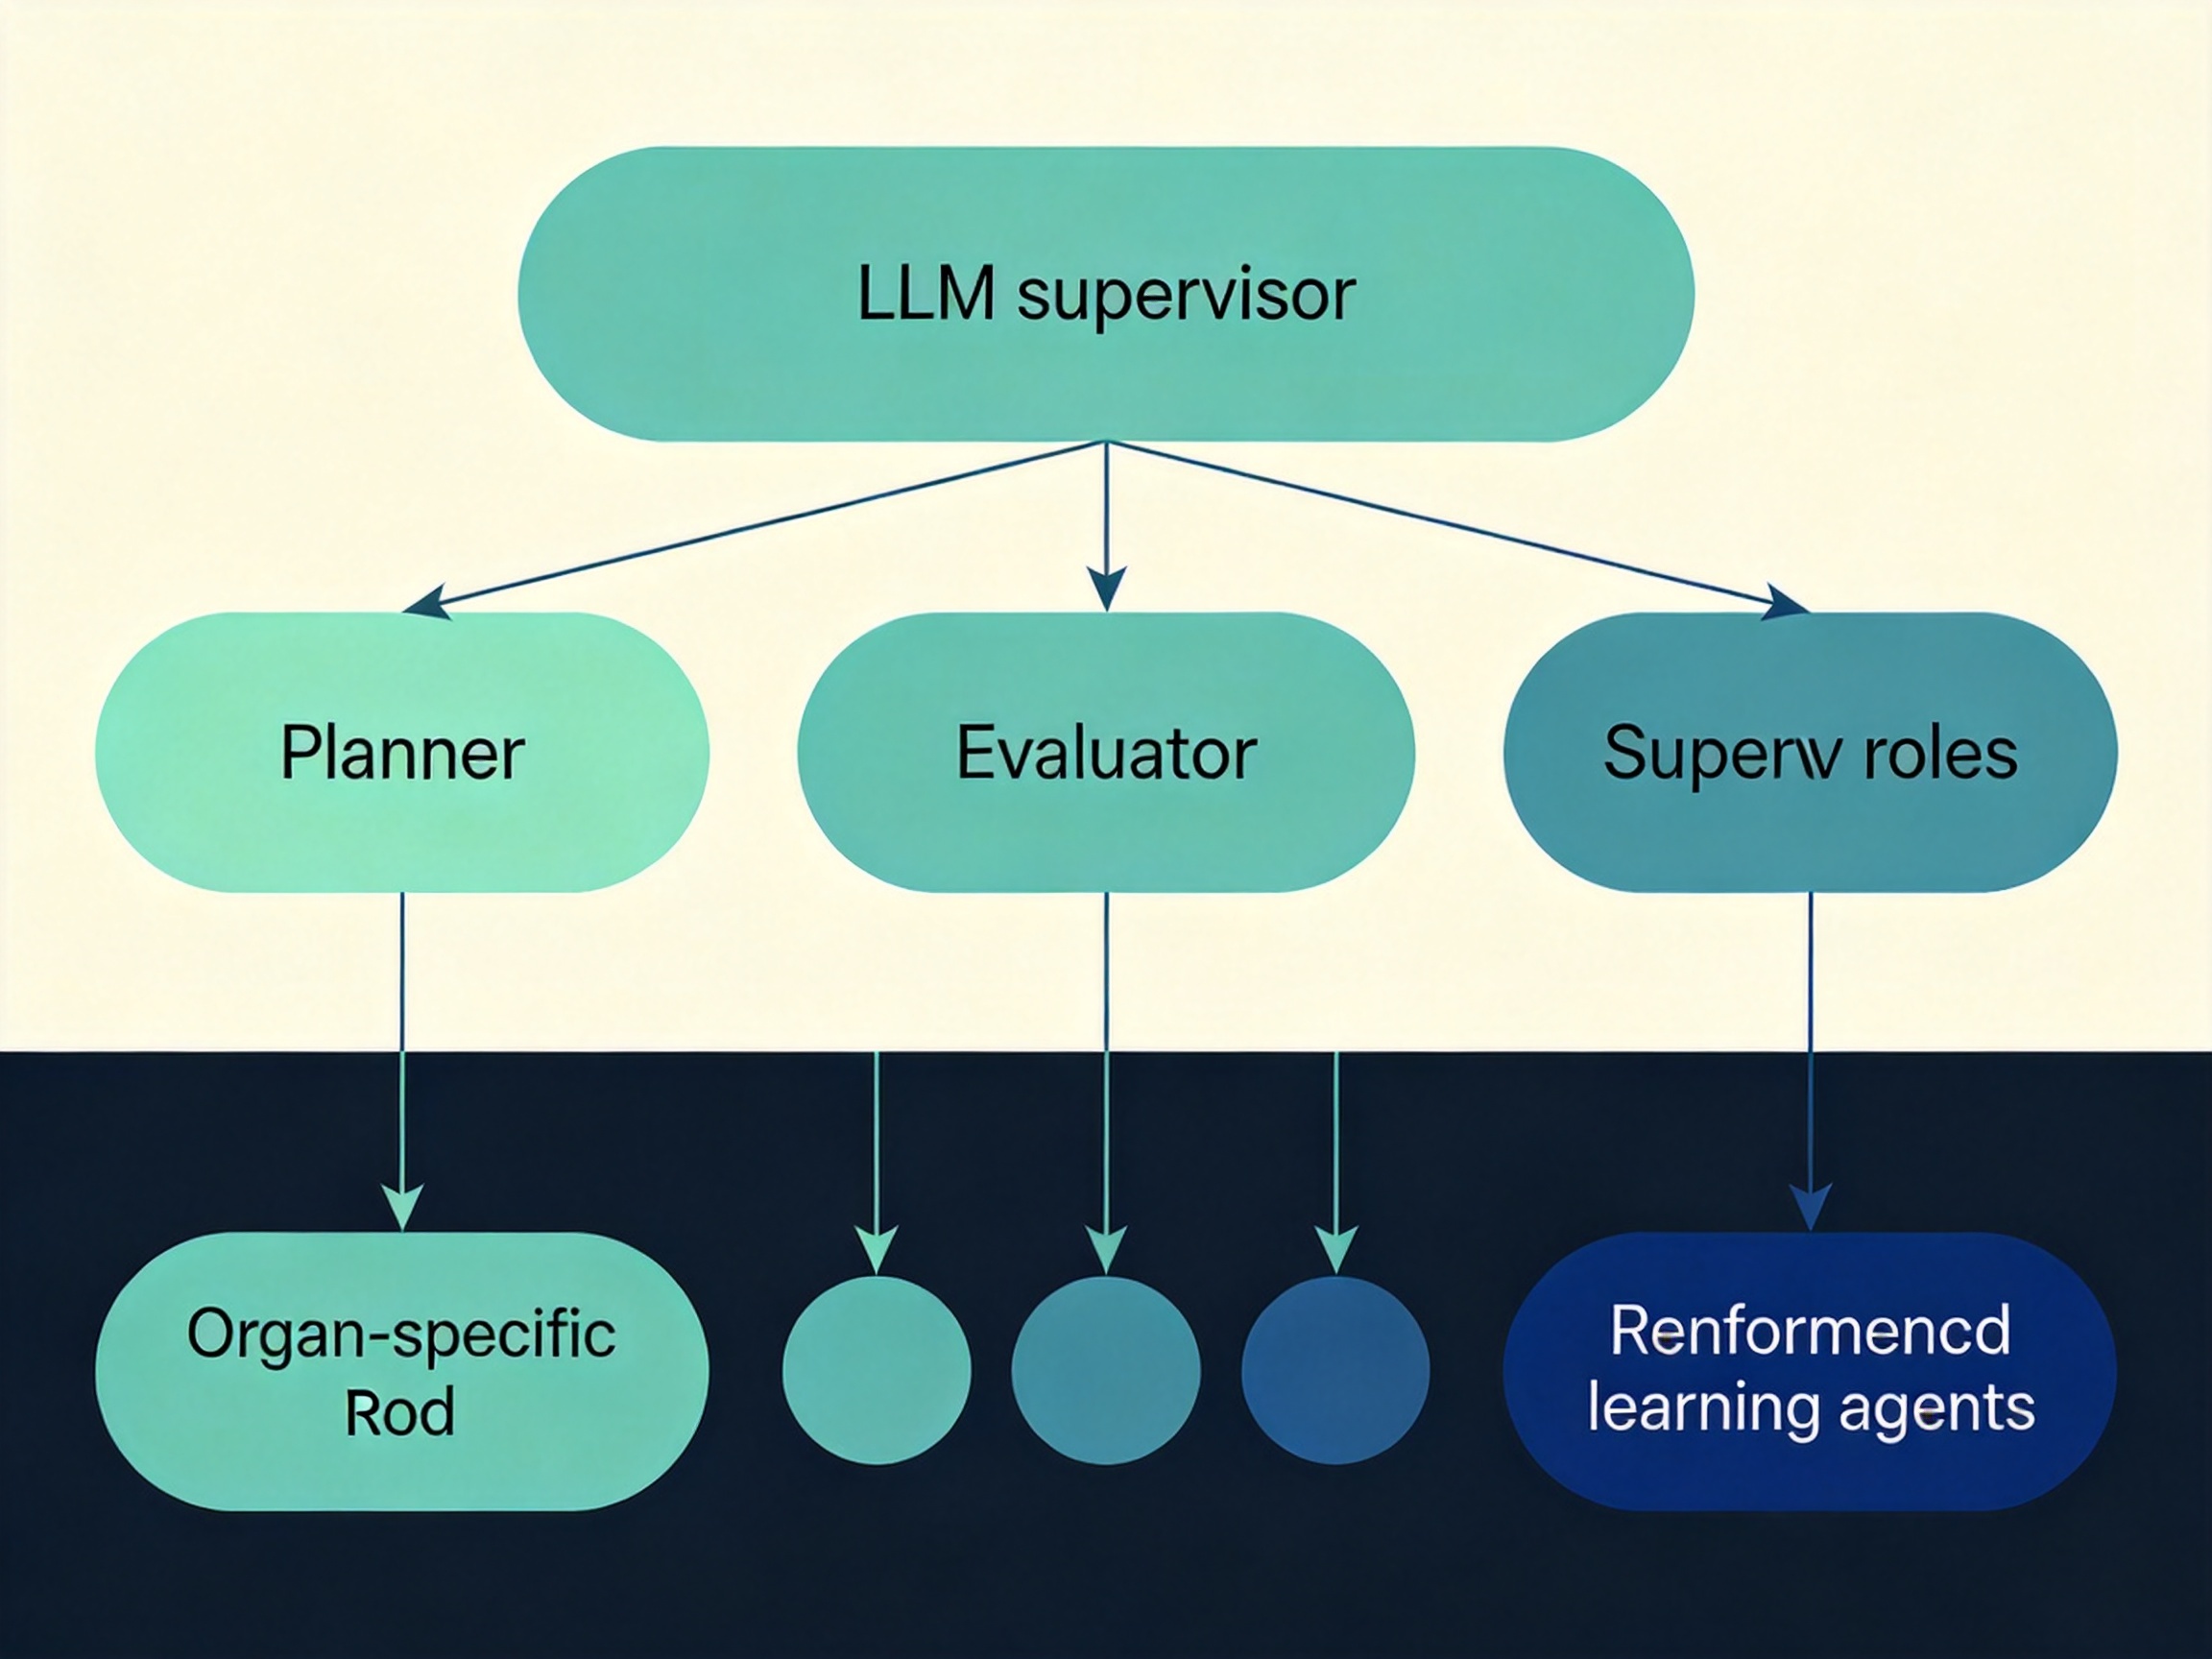
这套系统可以理解为一个「临床决策智能体」:它面对的不是一问一答,而是一连串需要持续优化的剂量决策。它的运作分两步:
- 第一步,LLM 监督层定方向:规划者提出修改方案,评估者判断方案是否满足剂量约束,监督者把控整体流程与目标;
- 第二步,RL 智能体微调剂量:各器官的模块化 RL 智能体在 LLM 协调下,执行一步又一步的剂量修改,直到所有临床约束都达标;
- 可选的「肺保护模式」:当计划已满足全部约束后,系统可进入肺保护模式,让肺 RL 智能体在 LLM 监督下继续单步压低肺剂量,追求更优的器官保护。
这套「上层大模型统筹 + 下层强化学习执行」的设计,既保留了大模型的理解与调度能力,又避免了让大模型反复「推理每一小步」带来的高成本与不稳定。
数据说话:临床目标达成率 74% → 98%,省下 75% 大模型调用
研究在 62 例局部晚期非小细胞肺癌回顾性病例上,把框架与本院 KBP 模型、纯 LLM 系统做了对比:
| 指标 | KBP 单独 | LLM 引导系统 | 变化 |
|---|---|---|---|
| 临床目标达成率 | 74% | 98% | 显著提升 |
| 需微调病例的大模型调用次数 | — | 1.7 ± 0.7 次(纯LLM为 6.7 ± 5.7) | 省下 75% |
| 平均计划时间 | — | 20.6 ± 15.7 分钟(纯LLM为 33.4 ± 32.1) | 更快 |
| 最慢病例耗时 | — | 58.5 分钟(纯LLM为 109.8) | 几乎减半 |
其中最值得注意的,是「少用了 75% 的大模型调用,还更快达标」——这正是「RL 管执行」带来的效率红利。
在肺保护模式上,系统把 V20(肺受量超 20 Gy 的体积占比)从 25.2% 压到 21.3%、平均肺剂量从 15.0 降到 14.2 Gy(均 p<0.001),甚至低于同一批患者的临床实际交付计划(V20 21.3% vs 24.6%)。代价是脊髓与食管的最大剂量略有上升,但仍全部满足约束——说明这套系统懂得「用别处的余量换肺的保护」。
应用前景与局限
这篇论文对「医疗智能体该长什么样」给出了一个务实的方向:
- 「监督」与「执行」分离,比让一个通用大模型控制每一步更安全、也更可扩展——这是多智能体协作在临床高精度任务里的一次落地示范;
- 类别级权重共享让 RL 智能体用极少样本就能泛化,降低了从零训练的成本门槛。
但它也有明确的局限:研究是回顾性的,用的是与团队此前 PlanningCopilot 相同的 62 例数据,并非独立外部验证;评估以本院剂量约束达标率为准,而非盲法临床可接受性或患者结局;肺剂量的进一步下降是「用别处余量换来的」,其真实的肺炎获益仍属建模而非观察到。作者也坦承,还需多中心、前瞻性的临床验证才能谈落地。
结论
这篇论文最大的价值,不在「又一个放疗 AI 刷高了某个体积指标」,而在于它展示了一种把大模型和强化学习各司其职的「临床决策智能体」架构:让 LLM 做它擅长的判断与调度,让 RL 做它擅长的重复优化,最终又快又好又省。
对于所有正在做医疗多智能体工作流的团队,这是一个值得借鉴的信号——智能体的竞争力,往往不在「一个模型有多强」,而在「不同能力如何被正确分工」。
| 论文标题 | A Modular Multi-Agent Reinforcement Learning Framework Guided by LLMs: Improving Quality and Efficiency of Treatment Planning in Lung Radiotherapy(LLM引导的模块化多智能体强化学习框架:提升肺癌放疗计划的质量与效率) |
| 作者 | Zipai Wang、Hao Guo、Yang Lei、Robert Samstein、Kenneth E. Rosenzweig、Ming Chao、Tian Liu、Junyi Xia、Jiahan Zhang;通讯作者:Jiahan Zhang |
| 机构 | 美国纽约西奈山伊坎医学院放射肿瘤科(Department of Radiation Oncology, Icahn School of Medicine at Mount Sinai, New York) |
| 期刊 | International Journal of Radiation Oncology*Biology*Physics(《国际放射肿瘤学·生物学·物理学杂志》,ASTRO 会刊) |
| 发表时间 | 2026 年 9 月 17 日在线发表(2026-05-26 投稿、2026-09-05 接收) |
| DOI | 10.1016/j.ijrobp.2026.09.008 |
| PubMed | PubMed 检索(暂未索引) |
论文原文信息地址:https://www.simoagent.com/blog/2026-09-28-llm-guided-multi-agent-rl-radiotherapy/
参考文献
- Wang Z, Guo H, Lei Y, Samstein R, Rosenzweig KE, Chao M, Liu T, Xia J, Zhang J. A Modular Multi-Agent Reinforcement Learning Framework Guided by LLMs: Improving Quality and Efficiency of Treatment Planning in Lung Radiotherapy. International Journal of Radiation OncologyBiologyPhysics, 2026. DOI: 10.1016/j.ijrobp.2026.09.008
相关问题
什么是临床决策智能体?
临床决策智能体是一种能自主执行医疗决策流程的 AI 系统——它不被动一问一答,而是像医生一样主动获取信息、调用专用工具、持续优化方案,并给出可解释的决策建议。在放疗计划里,它就体现为「大模型统筹判断 + 强化学习智能体执行剂量微调」的分工架构,把多步决策串成一条完整的工作流。
为什么放疗计划里要「大模型 + 强化学习」一起用?
因为它们各有所长:大模型擅长理解需求、统筹调度和做判断,但反复「推理每一小步」成本高且不稳定;强化学习擅长在明确目标下反复试错、精细优化,却难以独立理解复杂的临床语义。把「LLM 管大局、RL 管执行」结合起来,既能守住质量,又能省下大量大模型调用。
这套框架真的能落地临床吗?
还不能。论文是回顾性研究,用的是与团队此前工作相同的 62 例数据,并非独立外部验证;评估以本院剂量约束达标率为准,而非盲法临床可接受性或患者结局。肺剂量的下降也是「用别处剂量余量换来的」,其真实肺炎获益尚属建模。作者明确表示,还需多中心、前瞻性的临床验证。