
眼科AI智能体如何让诊断「有据可查」?AgentEYE融合眼底彩照、B超与循证检索,盲评200例在正确性、完整性、安全性与可溯源性上全面超越纯大模型
眼科AI如何让每个诊断都有据可查?浙江大学眼科团队联合新加坡、美国、波兰学者在《Cell Reports Medicine》发表AgentEYE,一个可审计的多模态智能体,能路由眼底彩照与B超影像、检索指南与网络证据,生成可溯源诊断报告;盲评200例显示其在诊断正确性、完整性、安全性与引用可溯源性上全面超越纯大模型。
研究背景:眼科诊断为什么「多模态」比「单模态」更难落地?
眼科诊断天然是多模态的:医生既看眼底彩照(看视网膜、视盘、黄斑),也看 B 超(看玻璃体、晶状体、眼轴),再把两者和临床指南、文献证据结合起来下结论。但市面上的医疗 AI 大多是「单任务选手」——要么只会读眼底照,要么只会判读 B 超,彼此割裂,还往往「只给结论、不给依据」。
这就带来一个尴尬:AI 说「怀疑青光眼」,医生却无从核验它凭什么这么说。缺乏可溯源的证据链,是医疗 AI 难进临床的深层原因之一——不是因为准确率不够,而是因为医生不敢信任一个「黑箱」。
2026 年 8 月,浙江大学医学院附属第二医院眼科中心金凯团队,联合新加坡、美国宾夕法尼亚大学、波兰等多国学者,在《Cell Reports Medicine》发表论文《An autonomous multimodal AI agent for evidence-grounded ophthalmic diagnosis》,提出 AgentEYE——一个「有据可查」的多模态眼科诊断智能体,正是冲着这个问题来的。
创新点:AgentEYE 如何把「看片」升级成「有据可查」的临床决策智能体?
AgentEYE 的核心思路,是把一个被动「看图说话」的模型,改造成一个能主动调用工具、检索证据、并给结论附上出处的临床决策智能体。它做了三件传统单任务 AI 做不到的事:
- 多模态路由:把眼底彩照和 B 超影像分别路由到专门的眼底工具和 B 超工具,各用各的「专家」来处理,而不是用一个通用模型硬啃两类影像;
- 循证检索:主动检索临床指南和网络医学证据,为诊断结论补充依据;
- 证据落地的报告:最终输出一份带引用、可审计的诊断报告,让医生能顺着引用追到原始依据。
换句话说,AgentEYE 追求的不仅是「答得对」,更是「答得让人信得过」——这是它与纯大模型最本质的区别。
技术原理:医学问答智能体「路由影像 + 检索证据 + 生成报告」的三步走
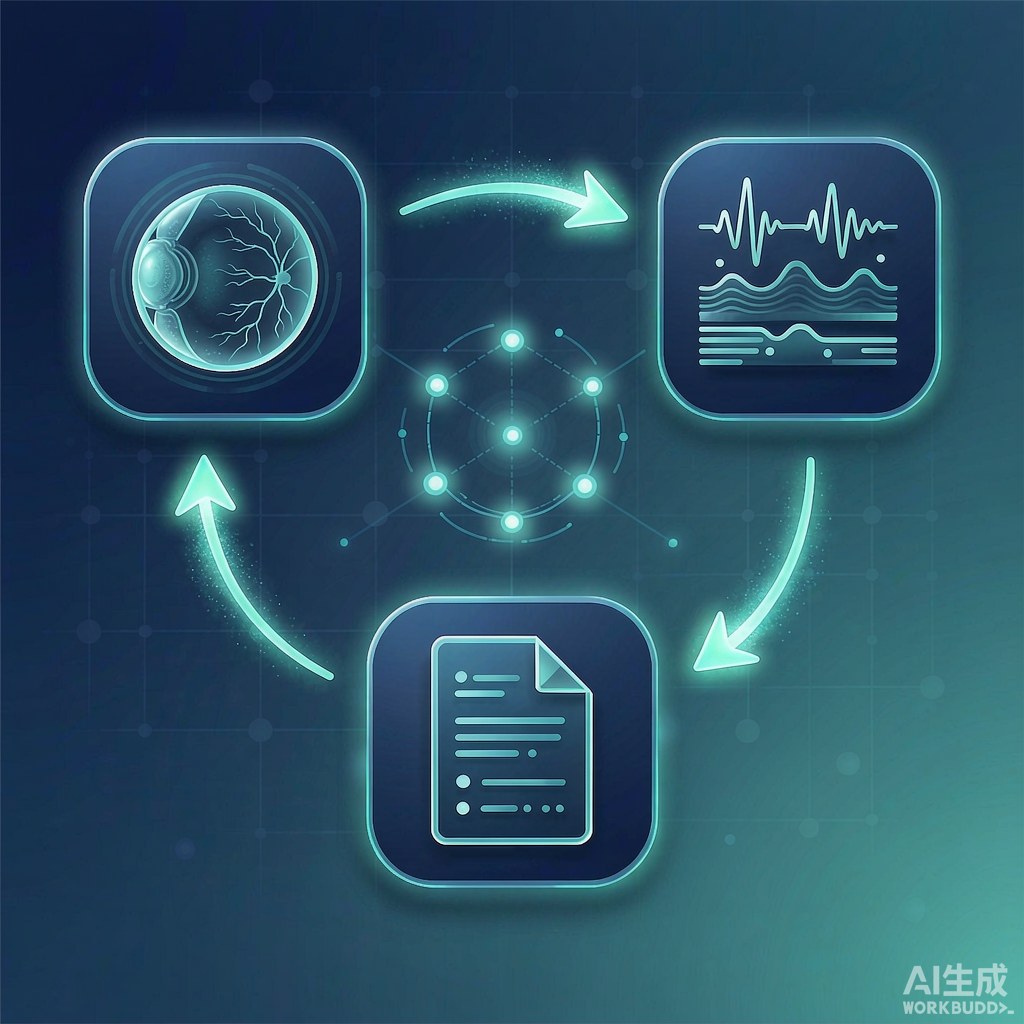
AgentEYE 的运作可以拆成一条清晰的医疗多智能体工作流:
- 第一步,影像路由:识别输入的影像是眼底彩照还是 B 超,分别交给对应的专用影像工具分析,得到结构化的影像发现;
- 第二步,证据检索:围绕待诊断的病情,从指南库和网络医学资源里检索相关证据;
- 第三步,证据融合成报告:把影像发现和检索到的证据融合,生成一份带引用的诊断报告,每条关键判断都能溯源。
这套「影像 + 证据」双轨并行的设计,正是「医学问答智能体」区别于普通大模型问答的地方——它不靠「背答案」,而是现场去「查依据」,让结论有出处、可复核。
数据说话:302 例内部 + 200 例盲评,可溯源性显著领先
论文的结论来自两层评估:
| 评估 | 规模 | 结果 |
|---|---|---|
| 内部基准 | 302 例 | 诊断正确性与完整性均高于纯大模型基线,也高于「去掉专用影像工具」的消融版本 |
| 三医生盲评 | 200 例 | 正确性、完整性、安全性、引用可溯源性四项全面优于「纯大模型自我引用」基线 |
这里有一个反直觉却很诚实的发现值得注意:去掉「证据检索」后,AgentEYE 的诊断表现和完整版差不多。也就是说,检索这一步的贡献,主要不是「让诊断更准」,而是让结论可溯源、可审计——它解决的是「信任」问题,而不是「准确率」问题。
这也解释了作者为什么把 AgentEYE 定位为「可追溯的决策支持原型」:它最值钱的不是多对了几道题,而是每一份结论都能被医生顺着引用查证。此外,外部数据集分析显示,其表现随数据分布变化而波动(distribution-dependent),提示还需多中心前瞻验证。
应用前景与局限
AgentEYE 的方向——让 AI 诊断「有据可查」——对临床落地有直接的借鉴意义:
- 可审计性是医疗 AI 从「演示」走向「上临床」的硬门槛,AgentEYE 的「报告带引用」设计提供了一条可落地的路径;
- 多模态路由 + 证据检索的架构,可以迁移到其他「影像 + 证据」并重的专科。
但它也有明确的局限:研究是回顾性的,作者自己也强调「需要前瞻性多中心验证」;外部数据集上的分布依赖说明它还谈不上「开箱即用」;检索环节提升的是可溯源性而非原始准确率,意味着它更应作为医生的「决策支持」而非「独立诊断者」。
结论
AgentEYE 这篇论文最大的价值,不在「又一个眼科 AI 刷高了准确率」,而在于它把焦点从「答得对不对」转到了「答得让不让人信」。
对一个准备进入临床的医疗 AI 来说,可溯源的证据链和可审计的报告,往往比多提升几个百分点的准确率更重要。这也给所有做临床决策智能体的团队提了个醒:让 AI 讲清楚「它凭什么这么说」,可能才是它真正被医生接纳的入场券。
| 论文标题 | An autonomous multimodal AI agent for evidence-grounded ophthalmic diagnosis(面向循证眼科诊断的自主多模态AI智能体) |
| 作者 | Kai Zhao、Qun Sun、Dahao Kang、Tingyu Yu、Weiyi Han、Rui Yao、Rupesh Agrawal、Gui-shuang Ying、Andrzej Grzybowski;通讯作者:Kai Jin(金凯) |
| 机构 | 浙江大学医学院附属第二医院眼科中心(浙江省眼科重点实验室等)、中国矿业大学、新加坡国立健保集团眼科研究所/新加坡眼科研究所、美国宾夕法尼亚大学佩雷尔曼医学院、波兰眼科学基金会等 |
| 期刊 | Cell Reports Medicine(《细胞报告·医学》) |
| 发表时间 | 2026 年 8 月 18 日(第 7 卷第 8 期,2026 年 8 月 5 日在线先行发布) |
| DOI | 10.1016/j.xcrm.2026.102969 |
| PubMed | PMID 42556343 |
论文原文信息地址:https://www.simoagent.com/blog/2026-09-25-agenteye-evidence-grounded-ophthalmic-diagnosis/
参考文献
- Zhao K, Sun Q, Kang D, Yu T, Han W, Yao R, Agrawal R, Ying GS, Grzybowski A, Jin K. An autonomous multimodal AI agent for evidence-grounded ophthalmic diagnosis. Cell Reports Medicine, 2026;7(8):102969. DOI: 10.1016/j.xcrm.2026.102969
相关问题
什么是临床决策智能体?
临床决策智能体是一种能自主执行医疗决策流程的 AI 系统——它会像医生一样主动调取病历、调用专用分析工具、检索证据,并给出可解释、可溯源的诊断建议,而不是被动地一问一答。它的关键在于「能规划、能调用工具、能给出依据」,把多步诊疗串成一条完整的工作流。
医学问答智能体和普通大模型有什么区别?
普通大模型靠「背答案」来回答,可能答得对却讲不清依据;医学问答智能体则现场「查依据」——先调用影像工具、再检索指南和文献,最后把结论和出处一起给出来。区别不在「会不会答」,而在「答得能不能被复核」,这正是医疗场景最看重的一点。
AgentEYE 的「证据检索」到底有没有提升诊断准确率?
论文给出了一个反直觉的诚实结论:去掉证据检索后,AgentEYE 的诊断表现和完整版相近。也就是说,检索这一步的贡献主要不是「让诊断更准」,而是「让结论可溯源、可审计」——它解决的是医生对 AI 的「信任」问题,而非单纯提升准确率。