
临床预测模型如何摆脱「医生看不懂的黑箱」?HACHI 人机协同框架让 AI 智能体与临床专家共创可解释模型,两个真实任务胜出、建模不到 8 小时
研究背景:临床预测模型为什么「越准越没人用」?
临床预测模型(Clinical Prediction Model,CPM)做的事很朴素:把病人身上随手可得的信息,换算成一个可以指导决策的风险判断。ICU 里评估死亡风险的 SOFA 评分、急诊判断儿童头部外伤要不要做 CT 的 PECARN 规则,都属于这一类。
这类模型在临床里恰恰最受欢迎,因为它们简单、可解释、医生心算就能用、还能被审计和修正。但问题也在这里——要造出一个既简单又好用的模型,极难。用论文作者的话说,「魔鬼藏在细节里」:用哪些数据、怎么定义变量、怎么评估效果,每一个微小决定都会影响最终模型,需要临床专家、数据科学家、信息学家反复协作打磨。
一旦要把非结构化的临床笔记(病历里那段自由书写的文字)纳入建模,难度更是成倍放大——笔记里能提炼出的概念几乎是无限的。于是行业里出现了两种极端:要么是医生信任但过于简陋的规则评分,要么是性能更强但完全不可解释的「黑箱」深度学习模型。
加州大学旧金山分校(UCSF)Jean Feng 团队 2026 年在《npj Digital Medicine》发表的工作,就是要在这两个极端之间,凿出一条新路。
创新点:不拼更大的模型,拼「人机怎么分工」
这套框架叫 HACHI,全称 Human+Agent Co-design for Healthcare Instruments(人机协同设计医疗工具),名字取自忠犬八公(Hachikō)——寓意「像训犬一样,通过反复反馈来迭代学习」。
它的核心主张出人意料地克制:不追求让 AI 独自产出更强的黑箱模型,而是把 AI 智能体当成一个「不知疲倦的候选因子挖掘工」,把最终拍板权牢牢交给人。
HACHI 把工作拆成两层:
- AI 智能体负责底层苦力:在海量临床笔记里检索可能相关的概念,把它们翻译成一条条「是/否」问题(比如「这条笔记是否提到意识丧失」),检查这些概念是否真的出现在笔记中,并自动测试不同概念组合的预测效果。
- 临床专家负责高层把关:审阅 AI 挖出来的因子,判断哪些是真实信号、哪些是数据泄漏,再修改提示词、细化概念定义、剔除问题数据、调整评估方式。
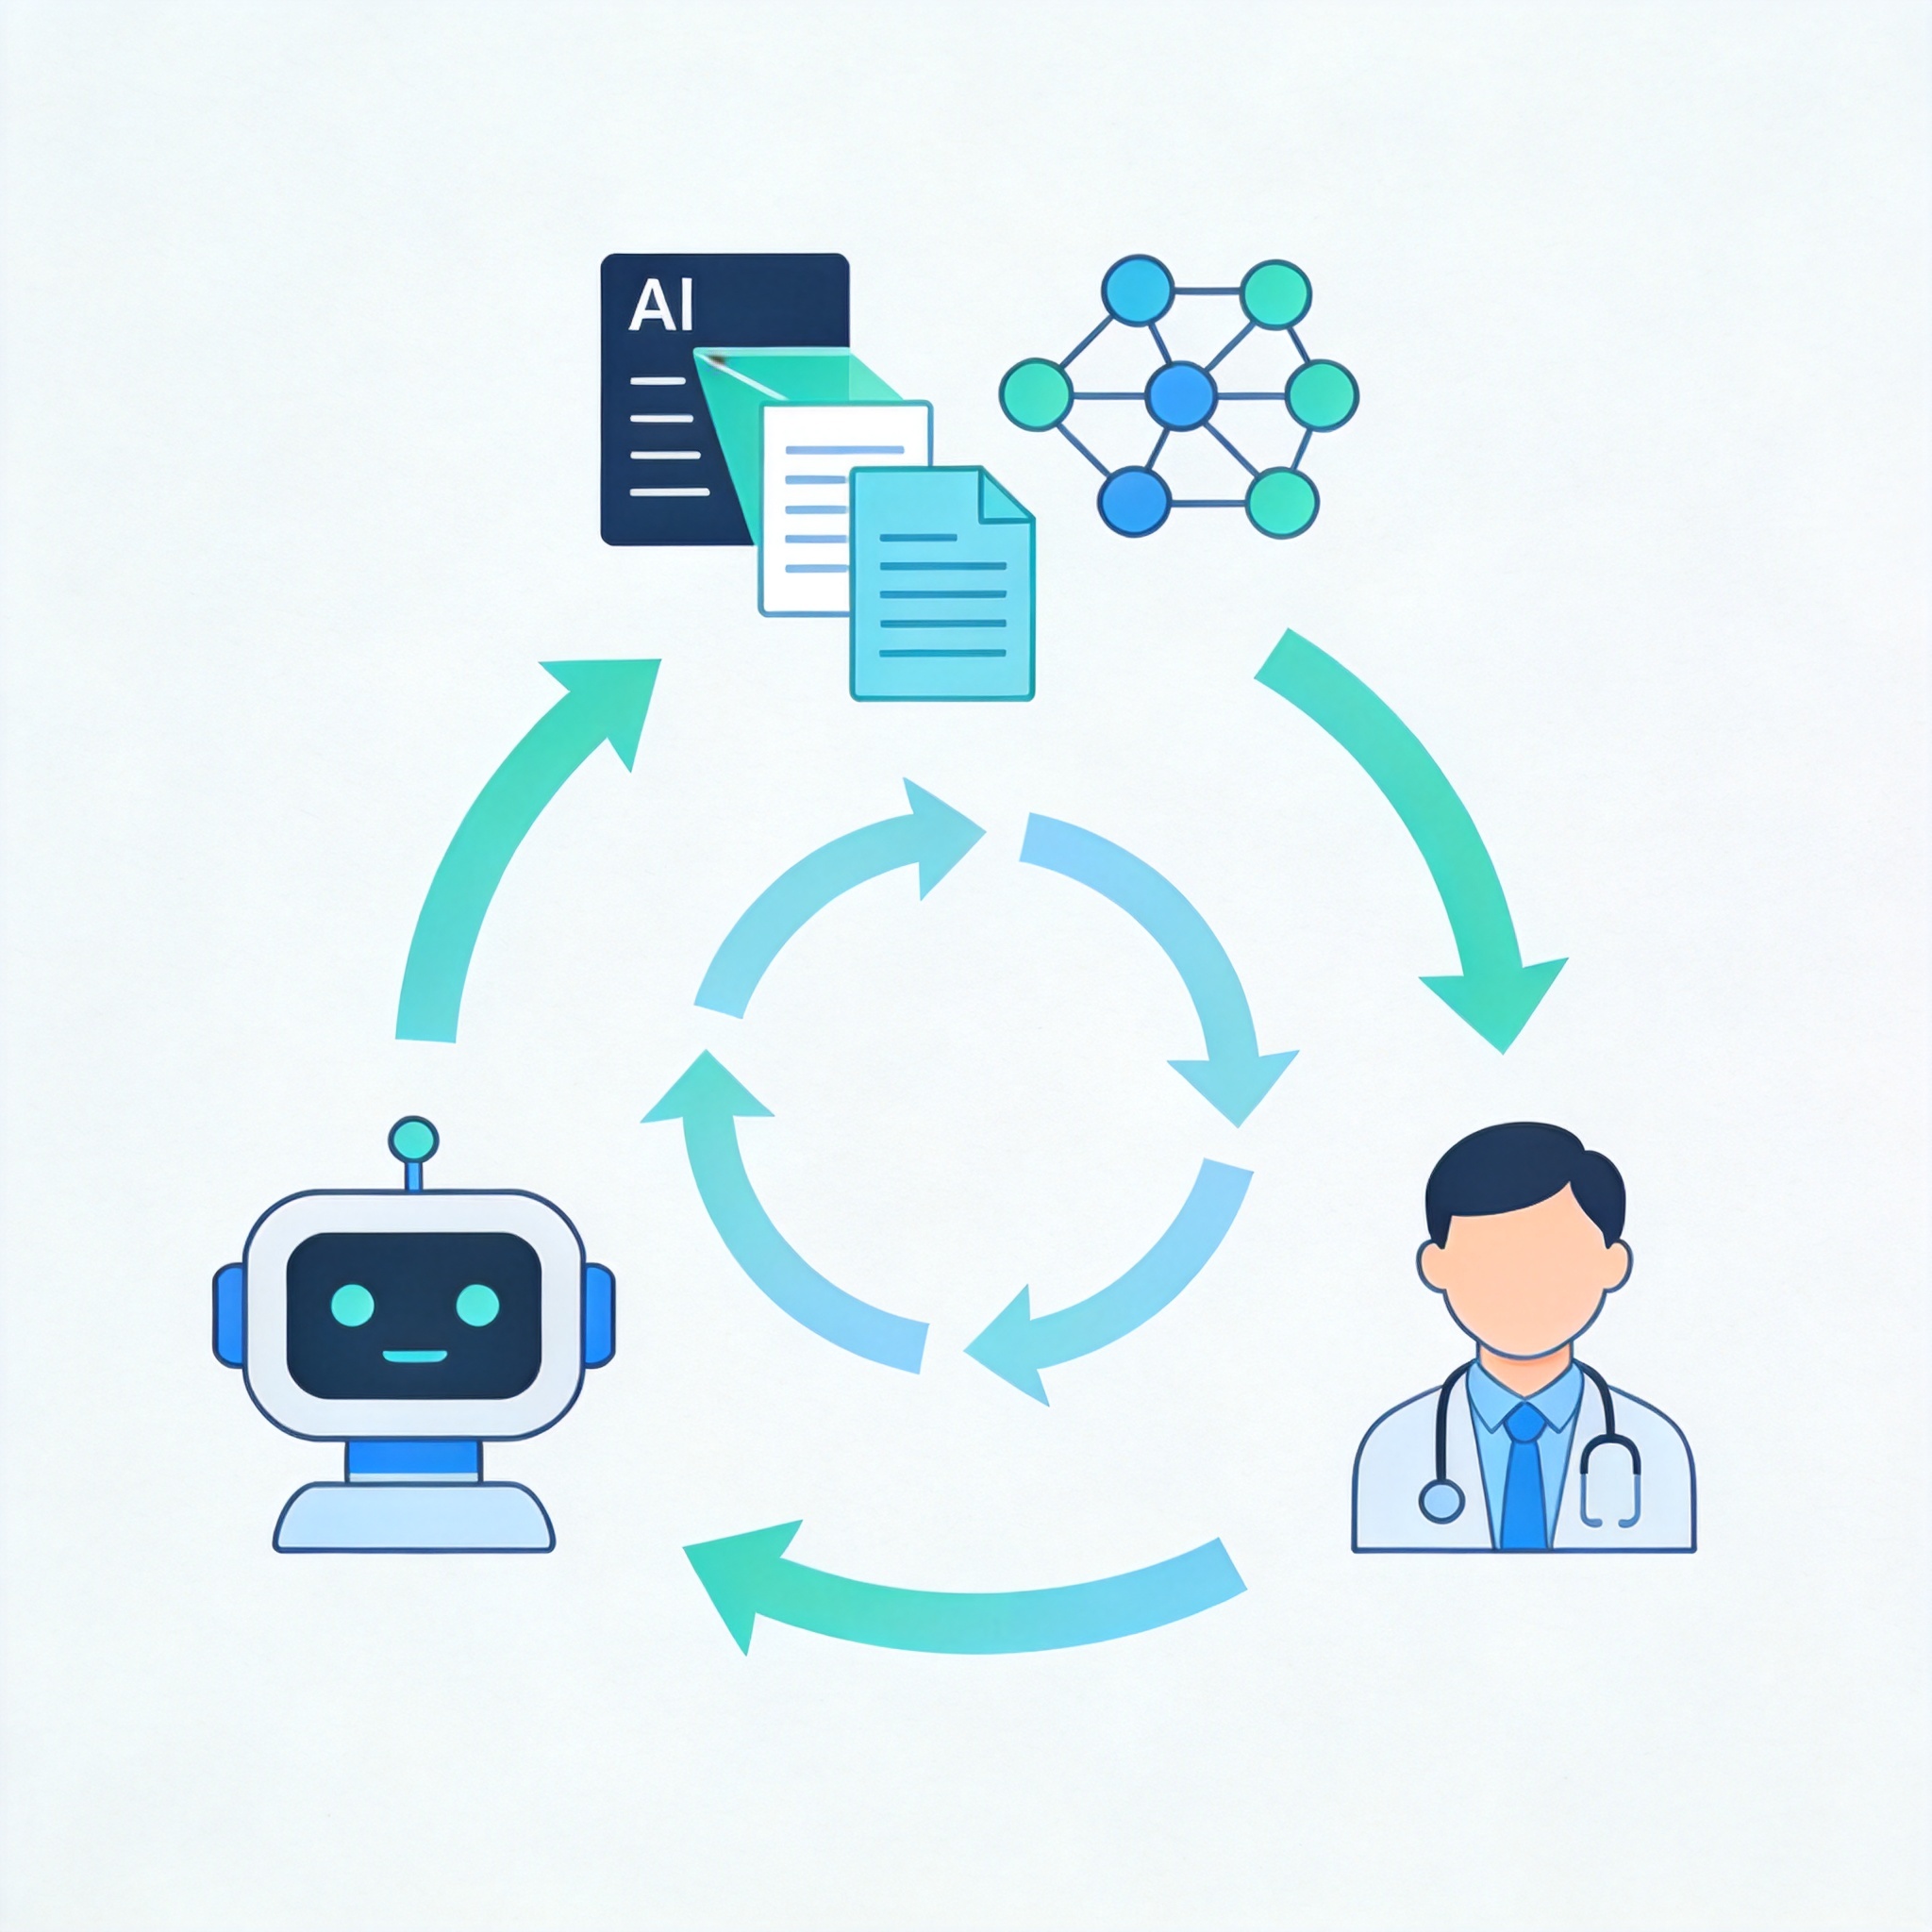
这套框架围绕三个原则运转:透明性(每一步都能被专家审查)、可引导性(专家能通过提示词和修改实时纠偏)、双向学习(专家也能从 AI 挖出的新发现中获得启发,反哺下一轮)。
技术原理:把黑箱拆成一串「是/否」问题
HACHI 产出的不是深度网络,而是一类叫**概念瓶颈模型(Concept Bottleneck)**的可解释结构——模型本质上是若干条「是/否」问题的线性组合。
工作流是一个循环:
- AI 智能体从临床笔记里提出候选概念,转成是非题;
- 自动检查这些概念在笔记中的出现情况;
- 测试不同组合,看哪个组合对预测目标最有帮助;
- 专家审阅结果,指出「这个因子是泄漏」「这个概念太含糊,不同医生理解会不一致」,再回炉调整。
一轮一轮滚下去,直到模型既能解释、又够准。论文特别强调,这个过程把「人」放在了纠错和定方向的位置,而不是装饰性的签字盖章。
数据说话:两个真实任务,都胜过了既有方法
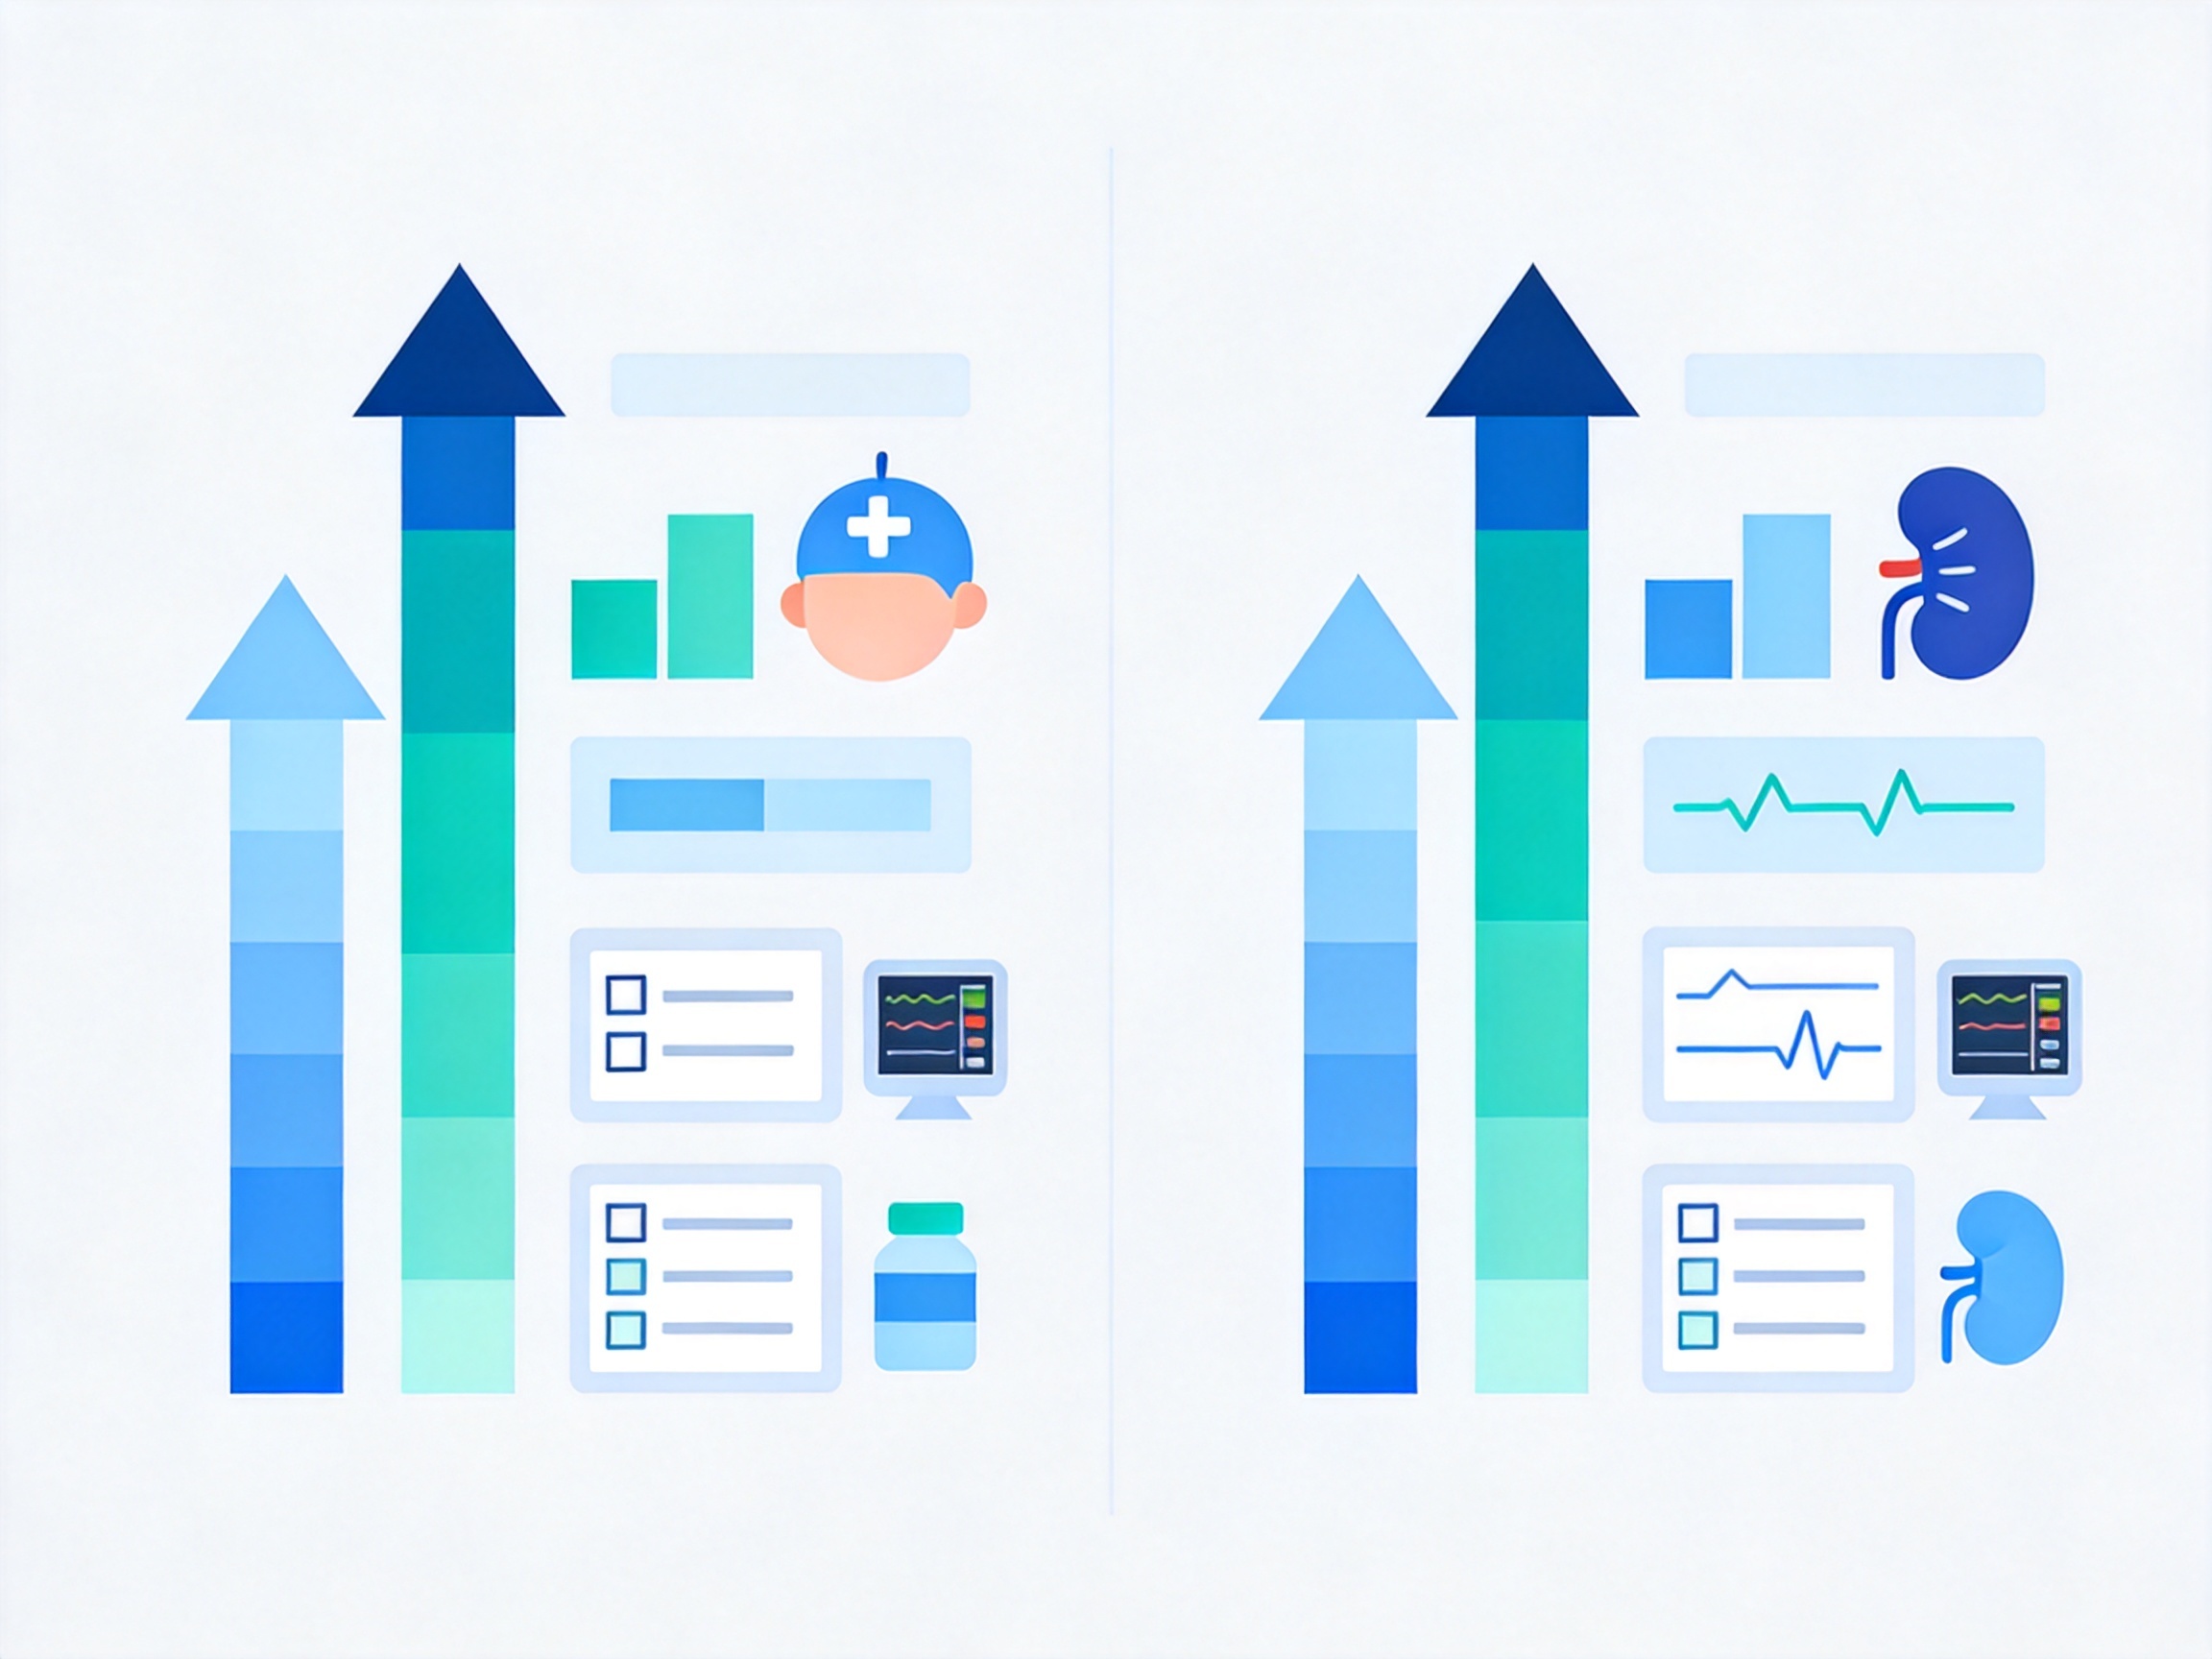
团队在两个真实临床任务上验证了 HACHI:
任务一:儿童创伤性脑损伤(TBI)。 针对头部外伤后就诊的儿童,判断最终是否确诊 TBI。HACHI 最终产出一个五因子模型,因子包括意识丧失、精神状态改变、头痛、头部创伤、步态正常。它在论文所用数据集上优于经典的 PECARN 规则和「一次性让 AI 列因子」的非迭代基线。
任务二:成人术后急性肾损伤(AKI)。 用术前麻醉笔记预测术后 7 天内是否发生 AKI。HACHI 既找出了肾功能不全、糖尿病等公认危险因子,也挖出了血细胞比容、白细胞增多、心功能不全、手术相关风险、药物相关因素等容易被忽视的信号,在内部和跨时间段评估中均优于 Kheterpal 模型等基线。
更值得玩味的是它揪出的「伪信号」:在 TBI 任务早期,AI 一度学会了「笔记里是否提到格拉斯哥昏迷评分(GCS)」这个因子——可这反映的是医生写病历的文档习惯,不是患儿的真实病情;「脑出血」这个因子则通常要等影像检查之后才知道,属于典型的信息泄漏。正是专家的反复把关,才把这些看似漂亮的「假聪明」信号挡在门外。
效率上,团队报告只需 3~4 轮专家反馈、不到 8 小时就能建出像样的模型,而传统流程往往要拖上好几个月。
应用前景与局限
HACHI 的价值不在「刷新某个准确率纪录」,而在于它提供了一条可解释、可审计、可快速迭代的建模路径,让临床预测模型既保留医生信任的「透明」属性,又借到了 AI 的算力和速度。
但它离「可以直接临床部署」还有明确距离:
- 结果仍绑定在论文所用的开发与评估环境上,作者自己明确声明「不应被解读为已具备部署就绪性」;
- 后续仍需前瞻性验证、可用性评估,并系统处理公平性、偏倚与公平分配(fairness/bias/equity)问题;
- 两个任务覆盖的病种与机构有限,跨机构、跨人群的泛化还需更多检验;
- 论文未给出可直接复算的统一 AUC 等核心指标,部分结论以「优于基线」的定性表述呈现,需等正式刊出版本补齐。
结论
这篇论文给出的是一个清醒的信号:医疗 AI 的下一程,未必是更大的模型,而是更好的协作。 与其让 AI 单打独斗产出医生看不懂的黑箱,不如把 AI 智能体定位成「挖因子、跑组合」的苦力,把「判断什么可信」的裁判权留给临床专家——因为只有人,才分得清哪些是真实的风险信号,哪些只是病历写法的影子。
当行业里铺天盖地地谈论「AI 替代医生」时,HACHI 用一场「人机共创」的实践提醒我们:最可靠的那道保险,依然是人。
| 论文标题 | Human-AI co-design for clinical prediction models(人机协同设计临床预测模型) |
| 作者 | Jean Feng(通讯作者)、Avni Kothari、Patrick Vossler、Andrew Bishara、Lucas Zier、Newton Addo、Aaron Kornblith、Yan Shuo Tan、Chandan Singh |
| 机构 | 美国加州大学旧金山分校(UCSF);新加坡国立大学(NUS);微软研究院(Microsoft Research) |
| 期刊 | npj Digital Medicine |
| 发表时间 | 2026 年 6 月 |
| DOI | 10.1038/s41746-026-02838-5 |
| PubMed | PMID: 42251137 |
论文原文信息地址:https://www.simoagent.com/blog/2026-09-19-hachi-human-ai-codesign-clinical-prediction/
参考文献
- Feng J, Kothari A, Vossler P, Bishara A, Zier L, Addo N, Kornblith A, Tan YS, Singh C. Human-AI co-design for clinical prediction models. npj Digital Medicine, 2026. DOI: 10.1038/s41746-026-02838-5
相关问题
HACHI 和「让 AI 直接生成一个模型」有什么区别?
区别在于人是否真正参与决策。让 AI 一次性列出预测因子,AI 会倾向于「什么相关列什么」,很容易把数据泄漏或文档习惯当成真信号。HACHI 的关键是把专家放进迭代循环里,用「透明性 + 可引导性」让专家能随时纠偏、剔假,最终产出的是医生能看懂、能审计的透明模型。
为什么说「简单线性模型」反而比大模型更值得信任?
因为临床落地要的不只是准确率,更是「医生愿意用、出问题能追责」。一串「是/否」问题组成的线性模型,医生一眼就能看懂逻辑、心算就能用、还能指出哪一步错了;而黑箱大模型即使更准,医生不敢信、也不敢为自己的判断背书,落地自然受阻。